1000+ câu Trắc nghiệm Nhập môn xử lý ngôn ngữ tự nhiên có đáp án - Phần 26
30 câu hỏi
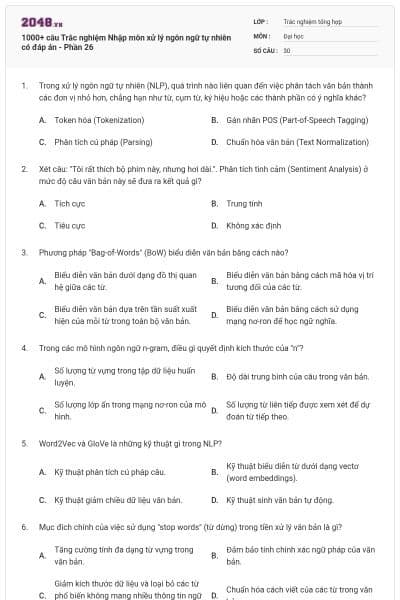
Token hóa (Tokenization)
Gán nhãn POS (Part-of-Speech Tagging)
Phân tích cú pháp (Parsing)
Chuẩn hóa văn bản (Text Normalization)
Chọn đáp án A
Tích cực
Trung tính
Tiêu cực
Không xác định
Chọn đáp án A
Biểu diễn văn bản dưới dạng đồ thị quan hệ giữa các từ.
Biểu diễn văn bản bằng cách mã hóa vị trí tương đối của các từ.
Biểu diễn văn bản dựa trên tần suất xuất hiện của mỗi từ trong toàn bộ văn bản.
Biểu diễn văn bản bằng cách sử dụng mạng nơ-ron để học ngữ nghĩa.
Chọn đáp án C
Số lượng từ vựng trong tập dữ liệu huấn luyện.
Độ dài trung bình của câu trong văn bản.
Số lượng lớp ẩn trong mạng nơ-ron của mô hình.
Số lượng từ liên tiếp được xem xét để dự đoán từ tiếp theo.
Chọn đáp án D
Kỹ thuật phân tích cú pháp câu.
Kỹ thuật biểu diễn từ dưới dạng vectơ (word embeddings).
Kỹ thuật giảm chiều dữ liệu văn bản.
Kỹ thuật sinh văn bản tự động.
Chọn đáp án B
Tăng cường tính đa dạng từ vựng trong văn bản.
Đảm bảo tính chính xác ngữ pháp của văn bản.
Giảm kích thước dữ liệu và loại bỏ các từ phổ biến không mang nhiều thông tin ngữ nghĩa.
Chuẩn hóa cách viết của các từ trong văn bản.
Chọn đáp án C
Phân loại văn bản theo chủ đề.
Phân tích cảm xúc và thái độ trong văn bản.
Dịch văn bản từ ngôn ngữ này sang ngôn ngữ khác.
Xác định và phân loại các thực thể có tên (ví dụ: người, tổ chức, địa điểm) trong văn bản.
Chọn đáp án D
Cả hai đều nhằm mục đích giảm các từ về dạng gốc của chúng.
Cả hai đều sử dụng từ điển để tra cứu dạng gốc của từ.
Cả hai đều loại bỏ hoàn toàn hậu tố và tiền tố của từ.
Cả hai đều giữ lại tất cả các dạng biến thể của từ để phân tích.
Chọn đáp án A
Mạng nơ-ron hồi quy (Recurrent Neural Network - RNN).
Cơ chế tự chú ý (Self-attention).
Mạng nơ-ron tích chập (Convolutional Neural Network - CNN).
Mô hình Markov ẩn (Hidden Markov Model - HMM).
Chọn đáp án B

Học thông minh hơn mỗi ngày
Xem toàn bộ 30 câu hỏi và nhiều hơn nữa với tài khoản miễn phí
Đo tốc độ dịch của mô hình.
Đánh giá khả năng hiểu ngôn ngữ nguồn của mô hình.
Đo mức độ tương đồng giữa bản dịch của mô hình với bản dịch tham khảo.
Xác định ngôn ngữ nguồn và ngôn ngữ đích của văn bản.
Chọn đáp án C
Mối quan hệ phụ thuộc giữa các từ trong câu.
Cấu trúc ngữ pháp tổng thể của câu.
Ý nghĩa ngữ nghĩa của từng từ trong câu.
Loại từ (part-of-speech) của mỗi từ trong câu.
Chọn đáp án A
Phân cụm các văn bản tương tự nhau.
Đánh giá tầm quan trọng của từ trong một văn bản so với toàn bộ tập văn bản.
Giảm số chiều của dữ liệu văn bản.
Tăng cường tính biểu cảm của văn bản.
Chọn đáp án D
Dữ liệu hình ảnh tĩnh.
Dữ liệu dạng bảng.
Dữ liệu âm thanh độc lập.
Dữ liệu chuỗi tuần tự (ví dụ: văn bản, chuỗi thời gian).
Chọn đáp án C
Contextual embeddings có kích thước vectơ cố định, static embeddings thì thay đổi.
Static embeddings учитывают ngữ cảnh của từ, contextual embeddings thì không.
Contextual embeddings tạo ra biểu diễn khác nhau cho cùng một từ tùy thuộc vào ngữ cảnh sử dụng, static embeddings thì tạo ra biểu diễn cố định.
Static embeddings yêu cầu lượng dữ liệu huấn luyện lớn hơn contextual embeddings.
Chọn đáp án B
Trợ lý ảo (Chatbots).
Phân tích và nhận diện hình ảnh.
Phân tích tình cảm trên mạng xã hội.
Dịch máy tự động.
Chọn đáp án D
Huấn luyện mô hình ngôn ngữ từ đầu với dữ liệu lớn.
Sử dụng mô hình ngôn ngữ đã huấn luyện sẵn mà không cần điều chỉnh gì thêm.
Nén kích thước của mô hình ngôn ngữ để triển khai hiệu quả hơn.
Huấn luyện tiếp mô hình ngôn ngữ tiền huấn luyện trên một tập dữ liệu nhỏ hơn, cụ thể cho một nhiệm vụ nhất định.
Chọn đáp án D
Tiếng Việt có số lượng từ vựng ít hơn tiếng Anh.
Tiếng Việt có cấu trúc ngữ pháp đơn giản hơn tiếng Anh.
Tiếng Việt là ngôn ngữ đơn lập, có thanh điệu và không có dạng biến tố, đòi hỏi các phương pháp xử lý đặc thù.
Các công cụ NLP cho tiếng Việt phát triển hơn tiếng Anh.
Chọn đáp án C
Quá trình tạo ra câu trả lời tự động từ chatbot.
Quá trình xác định mục đích hoặc ý định của người dùng dựa trên câu nói của họ.
Quá trình chuyển đổi văn bản thành giọng nói trong chatbot.
Quá trình ghi nhớ lịch sử hội thoại của người dùng với chatbot.
Chọn đáp án B
Huấn luyện mô hình NLP với dữ liệu không nhãn.
Huấn luyện mô hình NLP chỉ với một lượng nhỏ dữ liệu.
Khả năng của mô hình NLP thực hiện nhiệm vụ trên các lớp hoặc nhãn mà nó chưa từng được huấn luyện trực tiếp.
Khả năng của mô hình NLP tự động sửa lỗi chính tả trong văn bản.
Chọn đáp án C
Tăng cường dữ liệu huấn luyện cho các mô hình dịch máy bằng cách tạo ra các biến thể của dữ liệu gốc.
Đánh giá chất lượng của mô hình dịch máy.
Cải thiện khả năng hiểu ngôn ngữ nguồn của mô hình NLP.
Giảm độ phức tạp tính toán của mô hình dịch máy.
Chọn đáp án A
Giảm số lượng tham số của mô hình.
Tăng tốc độ huấn luyện mô hình.
Cải thiện khả năng xử lý dữ liệu không có cấu trúc.
Cho phép mô hình tập trung vào các phần liên quan nhất của dữ liệu đầu vào khi đưa ra dự đoán.
Chọn đáp án D
Phân tích cấu trúc cú pháp của câu.
Biểu diễn văn bản dưới dạng đồ thị từ.
Biểu diễn tri thức và quan hệ giữa các thực thể để hỗ trợ suy luận và trả lời câu hỏi.
Tạo ra các biểu diễn vectơ cho từ và câu.
Chọn đáp án C
Dịch văn bản giữa nhiều ngôn ngữ khác nhau.
Chuyển giao kiến thức từ mô hình huấn luyện trên một ngôn ngữ sang ngôn ngữ khác, đặc biệt hữu ích cho các ngôn ngữ ít tài nguyên.
Đánh giá hiệu suất của mô hình NLP trên nhiều ngôn ngữ.
Chuẩn hóa văn bản đa ngôn ngữ về một định dạng chung.
Chọn đáp án B
Tăng độ chính xác của các mô hình NLP.
Giảm thời gian huấn luyện các mô hình NLP.
Tự động hóa quá trình gán nhãn dữ liệu huấn luyện.
Làm cho các quyết định của mô hình NLP trở nên dễ hiểu và minh bạch hơn cho con người.
Chọn đáp án D
Chọn lọc và kết hợp các câu quan trọng nhất từ văn bản gốc để tạo thành bản tóm tắt.
Diễn giải lại nội dung của văn bản gốc bằng ngôn ngữ mới ngắn gọn hơn.
Sử dụng mô hình sinh văn bản để tạo ra bản tóm tắt hoàn toàn mới.
Loại bỏ các thông tin không quan trọng trong văn bản gốc để tạo bản tóm tắt.
Chọn đáp án A
Các phương pháp tăng cường độ mạnh mẽ của mô hình NLP trước dữ liệu nhiễu.
Các kỹ thuật phát hiện lỗi và sửa lỗi trong văn bản.
Các kỹ thuật tạo ra dữ liệu đầu vào gây nhiễu một cách có chủ ý để đánh lừa các mô hình NLP.
Các phương pháp bảo vệ dữ liệu văn bản khỏi bị truy cập trái phép.
Chọn đáp án C
Phương pháp huấn luyện mô hình NLP trên dữ liệu không nhãn để giảm chi phí.
Phương pháp cho phép mô hình NLP học hiệu quả từ một lượng nhỏ dữ liệu huấn luyện, quan trọng khi dữ liệu nhãn khan hiếm.
Kỹ thuật giảm kích thước mô hình NLP để triển khai trên các thiết bị hạn chế về tài nguyên.
Kỹ thuật tăng tốc độ suy luận của mô hình NLP trong thời gian thực.
Chọn đáp án B
Khả năng tạo ra câu hỏi tự động từ văn bản.
Khả năng chuyển đổi câu hỏi từ dạng văn bản sang dạng truy vấn cơ sở dữ liệu.
Khả năng đọc và hiểu văn bản để trả lời các câu hỏi liên quan đến nội dung văn bản đó.
Khả năng tóm tắt nội dung chính của một đoạn văn bản dài.
Chọn đáp án C
Chỉ phát sinh từ lỗi thuật toán và không liên quan đến dữ liệu.
Chỉ ảnh hưởng đến tốc độ xử lý của mô hình, không ảnh hưởng đến kết quả.
Chỉ xảy ra khi mô hình được huấn luyện trên dữ liệu quá nhỏ.
Có thể phát sinh từ dữ liệu huấn luyện và dẫn đến kết quả không công bằng, phân biệt đối xử trong ứng dụng thực tế.
Chọn đáp án D
Tự động tăng cường dữ liệu huấn luyện bằng cách sinh dữ liệu giả.
Chọn lọc các mẫu dữ liệu "khó" hoặc "không chắc chắn" nhất để con người gán nhãn, giúp mô hình học hiệu quả hơn với ít dữ liệu hơn.
Phân chia dữ liệu huấn luyện thành các nhóm nhỏ hơn để huấn luyện song song.
Sử dụng phản hồi từ người dùng để điều chỉnh mô hình NLP trong quá trình sử dụng thực tế.
Chọn đáp án B
Bạn có thích hoạt động này không?
Hãy lưu hoặc chia sẻ nội dung này đến mọi người.
Gợi ý cho bạn

Ý tưởng của bạn, bài học của bạn
Tự thiết kế đề thi, bài giảng hoặc flashcard theo cách riêng.
Học liệu phổ biến Trắc nghiệm tổng hợp
Trắc nghiệm tổng hợp
Bài tập vừa sức, đúng lớp
Chọn nội dung phù hợp và tạo hoạt động cho lớp của bạn.