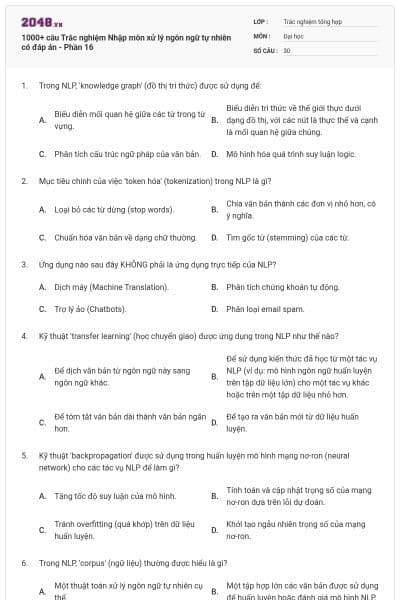
1000+ câu Trắc nghiệm Nhập môn xử lý ngôn ngữ tự nhiên có đáp án - Phần 16
30 câu hỏi
Biểu diễn mối quan hệ giữa các từ trong từ vựng.
Biểu diễn tri thức về thế giới thực dưới dạng đồ thị, với các nút là thực thể và cạnh là mối quan hệ giữa chúng.
Phân tích cấu trúc ngữ pháp của văn bản.
Mô hình hóa quá trình suy luận logic.
Chọn đáp án B
Loại bỏ các từ dừng (stop words).
Chia văn bản thành các đơn vị nhỏ hơn, có ý nghĩa.
Chuẩn hóa văn bản về dạng chữ thường.
Tìm gốc từ (stemming) của các từ.
Chọn đáp án B
Dịch máy (Machine Translation).
Phân tích chứng khoán tự động.
Trợ lý ảo (Chatbots).
Phân loại email spam.
Chọn đáp án B
Để dịch văn bản từ ngôn ngữ này sang ngôn ngữ khác.
Để sử dụng kiến thức đã học từ một tác vụ NLP (ví dụ: mô hình ngôn ngữ huấn luyện trên tập dữ liệu lớn) cho một tác vụ khác hoặc trên một tập dữ liệu nhỏ hơn.
Để tóm tắt văn bản dài thành văn bản ngắn hơn.
Để tạo ra văn bản mới từ dữ liệu huấn luyện.
Chọn đáp án B
Tăng tốc độ suy luận của mô hình.
Tính toán và cập nhật trọng số của mạng nơ-ron dựa trên lỗi dự đoán.
Tránh overfitting (quá khớp) trên dữ liệu huấn luyện.
Khởi tạo ngẫu nhiên trọng số của mạng nơ-ron.
Chọn đáp án B
Một thuật toán xử lý ngôn ngữ tự nhiên cụ thể.
Một tập hợp lớn các văn bản được sử dụng để huấn luyện hoặc đánh giá mô hình NLP.
Một thư viện phần mềm cho NLP.
Một phương pháp biểu diễn từ vựng.
Chọn đáp án B
Mô hình phân loại văn bản.
Mô hình ngôn ngữ.
Hệ thống nhận dạng thực thể có tên.
Hệ thống dịch máy.
Chọn đáp án B
Làm giảm tốc độ xử lý văn bản.
Khiến máy tính khó khăn trong việc hiểu đúng ý nghĩa của văn bản, do một từ hoặc cụm từ có thể có nhiều nghĩa khác nhau tùy theo ngữ cảnh.
Tăng yêu cầu về bộ nhớ lưu trữ dữ liệu văn bản.
Khó khăn trong việc dịch văn bản sang ngôn ngữ khác.
Chọn đáp án B
Giảm chiều dữ liệu word embedding.
Tính trọng số quan trọng của từ trong một văn bản so với tập hợp văn bản.
Phân tích cú pháp phụ thuộc.
Phát hiện ngôn ngữ của văn bản.
Chọn đáp án B

Học thông minh hơn mỗi ngày
Xem toàn bộ 30 câu hỏi và nhiều hơn nữa với tài khoản miễn phí
Phân tích ngữ pháp của câu.
Chia văn bản thành các câu.
Mô hình hóa chuỗi các đơn vị (ví dụ: từ, ký tự) liên tiếp trong văn bản.
Tìm kiếm và thay thế các cụm từ cố định.
Chọn đáp án C
Phân tích cấu trúc cú pháp của câu.
Xác định các thực thể có tên trong văn bản.
Xác định các cụm từ hoặc đại từ nào đề cập đến cùng một thực thể trong văn bản.
Phân loại văn bản theo chủ đề.
Chọn đáp án C
Phân loại văn bản.
Dự đoán xác suất xuất hiện của một chuỗi từ.
Trích xuất thông tin từ văn bản.
Tạo ra các câu hỏi từ văn bản.
Chọn đáp án B
Sự giống nhau về chính tả giữa hai từ.
Sự giống nhau về âm thanh giữa hai từ.
Mức độ tương đồng về ý nghĩa giữa hai từ, câu hoặc đoạn văn bản.
Mức độ tương đồng về cấu trúc cú pháp giữa hai câu.
Chọn đáp án B
Độ dài của văn bản.
Cường độ cảm xúc (mạnh hay yếu).
Hướng cảm xúc (tích cực, tiêu cực, trung lập).
Chủ đề chính của văn bản.
Chọn đáp án C
Chương trình kiểm tra chính tả.
Hệ thống trả lời câu hỏi tự động.
Công cụ dịch văn bản.
Phần mềm soạn thảo văn bản.
Chọn đáp án C
Không hiệu quả với văn bản dài.
Mất thông tin về thứ tự của từ trong câu.
Khó xử lý từ đồng nghĩa.
Yêu cầu tài nguyên tính toán lớn.
Chọn đáp án B
Ma trận đồng xuất hiện từ (co-occurrence matrix).
Cây cú pháp (parse tree) hoặc đồ thị phụ thuộc (dependency graph).
Vector đặc trưng TF-IDF.
Danh sách các thực thể có tên.
Chọn đáp án B
Sinh văn bản tự động.
Phân loại văn bản và nhận dạng thực thể có tên.
Dịch máy.
Tóm tắt văn bản.
Chọn đáp án B
Phát triển phần mềm hệ thống.
Tương tác giữa máy tính và ngôn ngữ loài người.
Thiết kế cơ sở dữ liệu.
Phân tích dữ liệu số.
Chọn đáp án B
Tạo ra phản hồi tự nhiên từ chatbot.
Xác định mục đích hoặc ý định của người dùng thông qua câu nói của họ.
Quản lý trạng thái hội thoại.
Lưu trữ lịch sử hội thoại.
Chọn đáp án B
Tiếng Việt có số lượng từ vựng lớn hơn tiếng Anh.
Tiếng Việt là ngôn ngữ đơn lập, không biến hình, và có tính đa nghĩa cao, gây khó khăn cho việc phân tích hình thái và ngữ nghĩa.
Tiếng Việt ít tài nguyên dữ liệu huấn luyện NLP hơn tiếng Anh.
Tiếng Việt không có bảng chữ cái.
Chọn đáp án B
Mô hình học mà không cần bất kỳ dữ liệu huấn luyện nào.
Mô hình có khả năng thực hiện một tác vụ mà không cần được huấn luyện trực tiếp trên tác vụ đó, mà chỉ dựa trên kiến thức đã học từ các tác vụ liên quan.
Mô hình chỉ được huấn luyện trên dữ liệu tổng hợp (synthetic data).
Mô hình có độ chính xác bằng 0 trên dữ liệu kiểm tra.
Chọn đáp án B
Hệ thống phân loại văn bản.
Hệ thống dịch máy.
Hệ thống tóm tắt văn bản.
Hệ thống trả lời câu hỏi.
Chọn đáp án B
Khả năng xử lý văn bản đa ngôn ngữ.
Khả năng xử lý song song và vấn đề 'vanishing gradient'.
Độ chính xác trong phân tích cú pháp.
Tốc độ học nhanh hơn trên dữ liệu nhỏ.
Chọn đáp án B
Mã hóa từ thành dạng số vector.
Phân tích cảm xúc của văn bản.
Dịch ngôn ngữ tự động.
Tóm tắt văn bản.
Chọn đáp án A
Huấn luyện lại toàn bộ mô hình từ đầu trên một tập dữ liệu mới.
Tiếp tục huấn luyện một mô hình đã được huấn luyện trước đó (pre-trained model) trên một tập dữ liệu cụ thể cho một tác vụ cụ thể.
Giảm kích thước của mô hình để triển khai trên thiết bị di động.
Tối ưu hóa tốc độ suy luận của mô hình.
Chọn đáp án B
Các từ mang nghĩa tiêu cực, cần loại bỏ để phân tích cảm xúc chính xác hơn.
Các từ phổ biến, ít mang thông tin ngữ nghĩa (ví dụ: 'là', 'của', 'và'), thường được loại bỏ để giảm nhiễu và tăng hiệu quả xử lý.
Các từ hiếm gặp, có thể gây lỗi trong mô hình ngôn ngữ.
Các từ viết tắt, cần được mở rộng để chuẩn hóa văn bản.
Chọn đáp án B
Phân tích cú pháp (Parsing).
Phân tích cảm xúc (Sentiment Analysis).
Biên dịch mã nguồn (Code Compilation).
Nhận dạng thực thể có tên (Named Entity Recognition).
Chọn đáp án C
Phân loại văn bản theo chủ đề.
Xác định và phân loại các thực thể có tên trong văn bản (ví dụ: tên người, tổ chức, địa điểm).
Tạo ra bản tóm tắt ngắn gọn của văn bản.
Dịch văn bản sang ngôn ngữ khác.
Chọn đáp án B
Phân tích cú pháp câu.
Giảm số lượng chiều dữ liệu văn bản.
Chuẩn hóa từ về dạng gốc.
Nhận dạng các thực thể có tên.
Chọn đáp án C
Bạn có thích hoạt động này không?
Hãy lưu hoặc chia sẻ nội dung này đến mọi người.
Gợi ý cho bạn

Ý tưởng của bạn, bài học của bạn
Tự thiết kế đề thi, bài giảng hoặc flashcard theo cách riêng.
Học liệu phổ biến Trắc nghiệm tổng hợp
Trắc nghiệm tổng hợp
Bài tập vừa sức, đúng lớp
Chọn nội dung phù hợp và tạo hoạt động cho lớp của bạn.