1000+ câu Trắc nghiệm Nhập môn xử lý ngôn ngữ tự nhiên có đáp án - Phần 21
30 câu hỏi
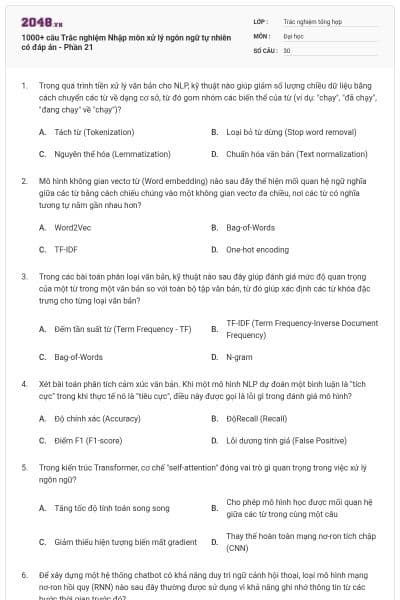
Tách từ (Tokenization)
Loại bỏ từ dừng (Stop word removal)
Nguyên thể hóa (Lemmatization)
Chuẩn hóa văn bản (Text normalization)
Chọn đáp án C
Word2Vec
Bag-of-Words
TF-IDF
One-hot encoding
Chọn đáp án B
Đếm tần suất từ (Term Frequency - TF)
TF-IDF (Term Frequency-Inverse Document Frequency)
Bag-of-Words
N-gram
Chọn đáp án A
Độ chính xác (Accuracy)
ĐộRecall (Recall)
Điểm F1 (F1-score)
Lỗi dương tính giả (False Positive)
Chọn đáp án B
Tăng tốc độ tính toán song song
Cho phép mô hình học được mối quan hệ giữa các từ trong cùng một câu
Giảm thiểu hiện tượng biến mất gradient
Thay thế hoàn toàn mạng nơ-ron tích chập (CNN)
Chọn đáp án B
Mạng nơ-ron truyền thẳng (Feedforward Neural Network)
Mạng nơ-ron tích chập (Convolutional Neural Network - CNN)
Mạng nơ-ron hồi quy dài-ngắn hạn (Long Short-Term Memory - LSTM)
Mạng tự mã hóa (Autoencoder)
Chọn đáp án C
Phân tích cấu trúc cú pháp của câu nguồn
Đảm bảo tính trôi chảy và ngữ pháp của câu dịch ở ngôn ngữ đích
Đối chiếu từ vựng giữa ngôn ngữ nguồn và ngôn ngữ đích
Xử lý các từ không có trong từ điển
Chọn đáp án B
Độ chính xác (Precision)
Độ đo F1 (F1-score)
ĐộRecall (Recall)
Độ đo AUC (AUC-score)
Chọn đáp án C
Đánh giá chất lượng bản dịch máy
Cải thiện tốc độ dịch máy
Giảm kích thước mô hình dịch máy
Tăng cường dữ liệu huấn luyện cho mô hình dịch máy
Chọn đáp án D

Học thông minh hơn mỗi ngày
Xem toàn bộ 30 câu hỏi và nhiều hơn nữa với tài khoản miễn phí
Phân tích cấu trúc ngữ pháp của một câu để xác định mối quan hệ giữa các từ
Chuyển đổi văn bản thành giọng nói
Phân loại văn bản theo chủ đề
Loại bỏ các từ không quan trọng trong văn bản
Chọn đáp án A
Thay thế từ OOV bằng từ đồng nghĩa
Sử dụng mã hóa theo cặp byte (Byte Pair Encoding - BPE) hoặc các phương pháp phân tách từ con
Bỏ qua hoàn toàn các từ OOV trong quá trình xử lý
Gán ngẫu nhiên vectơ cho các từ OOV
Chọn đáp án B
Các mệnh đề độc lập và phụ thuộc
Các từ khóa quan trọng nhất trong câu
Các cụm từ có nghĩa (ví dụ: cụm danh từ, cụm động từ)
Các thực thể có tên (Named Entities)
Chọn đáp án C
BERT chỉ xử lý văn bản từ trái sang phải, giống như các mô hình RNN truyền thống.
BERT xem xét cả ngữ cảnh bên trái và bên phải của một từ khi tạo biểu diễn vectơ từ đó.
BERT chỉ phù hợp cho các bài toán phân loại văn bản, không dùng được cho nhận dạng thực thể.
BERT là một mô hình ngôn ngữ dựa trên CNN, không phải Transformer.
Chọn đáp án B
Chọn lọc và kết hợp các câu quan trọng nhất từ văn bản gốc để tạo bản tóm tắt
Diễn giải lại nội dung của văn bản gốc bằng ngôn ngữ khác
Sử dụng mô hình sinh văn bản để tạo ra bản tóm tắt mới hoàn toàn
Loại bỏ các thông tin không quan trọng và giữ lại các từ khóa chính
Chọn đáp án A
So sánh số lượng từ chung giữa hai câu
Kiểm tra xem hai câu có cùng chủ đề hay không
Đếm số lượng thực thể có tên giống nhau
Sử dụng biểu diễn vectơ câu (sentence embeddings) và tính độ tương đồng cosine giữa chúng
Chọn đáp án D
NLTK (Natural Language Toolkit)
SpaCy
underthesea
Stanford CoreNLP
Chọn đáp án C
Nhận dạng giọng nói (Speech Recognition)
Tổng hợp tiếng nói (Text-to-Speech - TTS)
Dịch máy (Machine Translation)
Phân tích văn bản (Text Analytics)
Chọn đáp án B
Nhận dạng thực thể có tên (Named Entity Recognition)
Tóm tắt văn bản (Text Summarization)
Phân tích cú pháp (Syntactic Parsing)
Phân tích cảm xúc (Sentiment Analysis)
Chọn đáp án D
Sinh văn bản (Text Generation)
Dịch máy (Machine Translation)
Trích xuất thông tin (Information Extraction)
Phân loại văn bản (Text Classification)
Chọn đáp án C
Khả năng dự đoán chuỗi từ tiếp theo của mô hình ngôn ngữ
Tốc độ huấn luyện của mô hình ngôn ngữ
Kích thước bộ nhớ cần thiết để lưu trữ mô hình ngôn ngữ
Độ phức tạp của kiến trúc mô hình ngôn ngữ
Chọn đáp án A
Phân tích cấu trúc cú pháp của câu chứa từ đó
Xác định nghĩa chính xác của một từ trong ngữ cảnh cụ thể khi từ đó có nhiều nghĩa
Tìm ra các từ đồng nghĩa và trái nghĩa của từ
Chuyển đổi từ về dạng nguyên thể của nó
Chọn đáp án B
Tạo ra phản hồi tự nhiên và trôi chảy
Lưu trữ lịch sử hội thoại của người dùng
Xác định mục đích hoặc mong muốn của người dùng thông qua câu nói của họ
Chuyển đổi giọng nói của người dùng thành văn bản
Chọn đáp án C
Loại bỏ từ dừng (Stop word removal)
Nguyên thể hóa (Lemmatization)
Stemming
Phân tách từ thành đơn vị con (Subword tokenization)
Chọn đáp án D
Tăng tốc độ huấn luyện mô hình
Cho phép bộ giải mã (decoder) tập trung vào các phần liên quan của câu nguồn khi tạo từ dịch
Giảm độ phức tạp tính toán của mô hình
Cải thiện khả năng xử lý ngữ cảnh hai chiều của mô hình
Chọn đáp án B
Chỉ sử dụng dữ liệu từ một nguồn duy nhất để đảm bảo tính nhất quán
Tăng cường sử dụng các thuật toán phức tạp hơn để tự động loại bỏ thiên kiến
Đa dạng hóa dữ liệu huấn luyện và kiểm tra, đồng thời giám sát và đánh giá thiên kiến trong mô hình
Giấu thông tin nhạy cảm (ví dụ: giới tính, chủng tộc) trong dữ liệu huấn luyện
Chọn đáp án C
Các thực thể và mối quan hệ giữa chúng trong thế giới thực
Cấu trúc ngữ pháp của ngôn ngữ
Biểu diễn vectơ của từ và câu
Quy trình xử lý văn bản từ đầu đến cuối
Chọn đáp án A
Lịch sử các câu hỏi và câu trả lời trong hội thoại
Thông tin về ngữ cảnh hiện tại và mục tiêu của người dùng trong hội thoại
Các thực thể có tên được đề cập trong hội thoại
Cảm xúc của người dùng trong suốt hội thoại
Chọn đáp án B
Phân loại văn bản (Text Classification)
Tóm tắt văn bản (Text Summarization)
Phân tích cảm xúc tổng thể (Overall Sentiment Analysis)
Phân tích cảm xúc dựa trên khía cạnh (Aspect-Based Sentiment Analysis)
Chọn đáp án D
Học từ dữ liệu không có nhãn
Huấn luyện mô hình trên dữ liệu tổng hợp
Tổng quát hóa và thực hiện nhiệm vụ trên các lớp hoặc nhãn chưa từng thấy trong quá trình huấn luyện
Tăng tốc độ học của mô hình bằng cách bỏ qua một số mẫu dữ liệu
Chọn đáp án C
Khả năng mô hình tự động sửa lỗi sai trong quá trình xử lý ngôn ngữ
Khả năng hiểu và giải thích được lý do tại sao mô hình đưa ra một dự đoán hoặc quyết định cụ thể
Khả năng mô hình học hỏi từ ít dữ liệu huấn luyện hơn
Khả năng mô hình hoạt động hiệu quả trên nhiều ngôn ngữ khác nhau
Chọn đáp án B
Bạn có thích hoạt động này không?
Hãy lưu hoặc chia sẻ nội dung này đến mọi người.
Gợi ý cho bạn

Ý tưởng của bạn, bài học của bạn
Tự thiết kế đề thi, bài giảng hoặc flashcard theo cách riêng.
Học liệu phổ biến Trắc nghiệm tổng hợp
Trắc nghiệm tổng hợp
Bài tập vừa sức, đúng lớp
Chọn nội dung phù hợp và tạo hoạt động cho lớp của bạn.