1000+ câu Trắc nghiệm Nhập môn xử lý ngôn ngữ tự nhiên có đáp án - Phần 18
30 câu hỏi
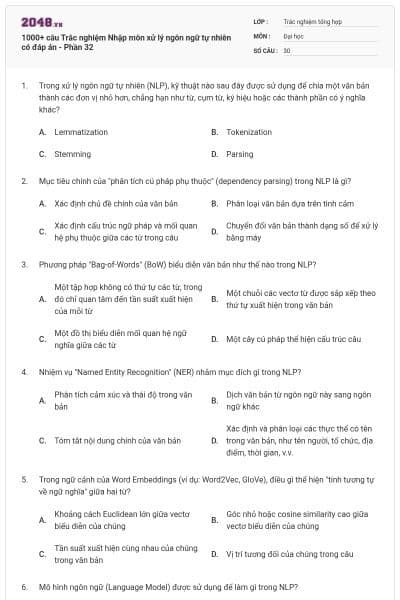
Trong xử lý ngôn ngữ tự nhiên (NLP), kỹ thuật nào sau đây được sử dụng để chia một văn bản thành các đơn vị nhỏ hơn, chẳng hạn như từ, cụm từ, ký hiệu hoặc các thành phần có ý nghĩa khác?
Lemmatization
Tokenization
Stemming
Parsing
Chọn đáp án B
Mục tiêu chính của "phân tích cú pháp phụ thuộc" (dependency parsing) trong NLP là gì?
Xác định chủ đề chính của văn bản
Phân loại văn bản dựa trên tình cảm
Xác định cấu trúc ngữ pháp và mối quan hệ phụ thuộc giữa các từ trong câu
Chuyển đổi văn bản thành dạng số để xử lý bằng máy
Chọn đáp án C
Phương pháp "Bag-of-Words" (BoW) biểu diễn văn bản như thế nào trong NLP?
Một tập hợp không có thứ tự các từ, trong đó chỉ quan tâm đến tần suất xuất hiện của mỗi từ
Một chuỗi các vectơ từ được sắp xếp theo thứ tự xuất hiện trong văn bản
Một đồ thị biểu diễn mối quan hệ ngữ nghĩa giữa các từ
Một cây cú pháp thể hiện cấu trúc câu
Chọn đáp án A
Nhiệm vụ "Named Entity Recognition" (NER) nhằm mục đích gì trong NLP?
Phân tích cảm xúc và thái độ trong văn bản
Dịch văn bản từ ngôn ngữ này sang ngôn ngữ khác
Tóm tắt nội dung chính của văn bản
Xác định và phân loại các thực thể có tên trong văn bản, như tên người, tổ chức, địa điểm, thời gian, v.v.
Chọn đáp án D
Trong ngữ cảnh của Word Embeddings (ví dụ: Word2Vec, GloVe), điều gì thể hiện "tính tương tự về ngữ nghĩa" giữa hai từ?
Khoảng cách Euclidean lớn giữa vectơ biểu diễn của chúng
Góc nhỏ hoặc cosine similarity cao giữa vectơ biểu diễn của chúng
Tần suất xuất hiện cùng nhau của chúng trong văn bản
Vị trí tương đối của chúng trong câu
Chọn đáp án B
Mô hình ngôn ngữ (Language Model) được sử dụng để làm gì trong NLP?
Phân tích cấu trúc cú pháp của câu
Xác định các thực thể có tên trong văn bản
Dự đoán xác suất xuất hiện của một từ hoặc một chuỗi từ trong một ngữ cảnh nhất định
Phân loại văn bản theo chủ đề
Chọn đáp án C
Kỹ thuật "Stemming" và "Lemmatization" có điểm chung gì trong tiền xử lý văn bản?
Cả hai đều chuyển đổi văn bản thành dạng số
Cả hai đều xác định cấu trúc ngữ pháp của câu
Cả hai đều loại bỏ các từ dừng (stop words) khỏi văn bản
Cả hai đều cố gắng đưa các từ về dạng gốc hoặc dạng cơ bản của chúng
Chọn đáp án B
Trong kiến trúc Transformer, cơ chế "Attention" (chú ý) đóng vai trò quan trọng như thế nào?
Để giảm thiểu số lượng tham số trong mô hình
Cho phép mô hình tập trung vào các phần liên quan nhất của dữ liệu đầu vào khi xử lý thông tin
Để tăng tốc độ tính toán của mô hình
Để chuẩn hóa dữ liệu đầu vào
Chọn đáp án A
"Phân tích tình cảm" (Sentiment Analysis) trong NLP nhằm mục đích gì?
Xác định cảm xúc, thái độ hoặc quan điểm được thể hiện trong văn bản
Dịch văn bản sang ngôn ngữ khác
Tóm tắt văn bản thành các ý chính
Sửa lỗi chính tả và ngữ pháp trong văn bản
Chọn đáp án C
Để đánh giá hiệu suất của một mô hình dịch máy, thước đo BLEU (Bilingual Evaluation Understudy) tập trung vào điều gì?
Độ chính xác ngữ pháp của bản dịch
Tính trôi chảy và tự nhiên của bản dịch
Mức độ trùng lặp n-gram giữa bản dịch của mô hình và bản dịch tham khảo
Khả năng bảo toàn ý nghĩa của bản dịch so với văn bản gốc
Chọn đáp án C
Xét tình huống bạn muốn xây dựng một hệ thống chatbot. Nhiệm vụ NLP nào sau đây là quan trọng nhất để chatbot có thể hiểu ý định của người dùng?
Phân tích cú pháp phụ thuộc
Nhận dạng ý định (Intent Recognition)
Sinh văn bản (Text Generation)
Phân tích tình cảm
Chọn đáp án B
Trong lĩnh vực "Sinh văn bản" (Text Generation), kỹ thuật "lấy mẫu nhiệt độ" (temperature sampling) ảnh hưởng đến đầu ra như thế nào?
Thay đổi tốc độ sinh văn bản
Điều chỉnh độ dài của văn bản được sinh ra
Kiểm soát tính ngẫu nhiên và đa dạng của văn bản được sinh ra; nhiệt độ cao hơn tạo ra văn bản ngẫu nhiên và sáng tạo hơn
Cải thiện tính nhất quán ngữ pháp của văn bản
Chọn đáp án C
Để xử lý ngôn ngữ có cấu trúc phức tạp và mối quan hệ phụ thuộc xa, kiến trúc mạng nơ-ron nào thường được ưu tiên hơn so với mạng nơ-ron truyền thẳng (Feedforward Neural Networks) thông thường?
Mạng nơ-ron hồi quy (Recurrent Neural Networks - RNNs) hoặc Transformer
Mạng nơ-ron tích chập (Convolutional Neural Networks - CNNs)
Mạng tự mã hóa (Autoencoders)
Mạng đối nghịch sinh (Generative Adversarial Networks - GANs)
Chọn đáp án A
Giả sử bạn có một tập dữ liệu lớn các bài đánh giá sản phẩm trực tuyến và bạn muốn phân loại chúng thành "tích cực", "tiêu cực" hoặc "trung lập". Nhiệm vụ NLP này được gọi là gì?
Nhận dạng thực thể có tên
Tóm tắt văn bản
Dịch máy
Phân loại tình cảm
Chọn đáp án D
Trong ngữ cảnh của mô hình Transformer, "Multi-Head Attention" (chú ý đa đầu) mang lại lợi ích gì so với "Single-Head Attention" (chú ý đơn đầu)?
Giảm độ phức tạp tính toán
Cho phép mô hình học được nhiều khía cạnh khác nhau của mối quan hệ giữa các từ trong câu, từ các "không gian biểu diễn" khác nhau
Tăng tốc độ hội tụ của mô hình
Cải thiện khả năng khái quát hóa của mô hình trên dữ liệu mới
Chọn đáp án B
Kỹ thuật nào sau đây giúp giảm thiểu vấn đề "từ không có trong từ vựng" (out-of-vocabulary - OOV) khi xử lý văn bản?
Stemming
Lemmatization
Sử dụng Byte-Pair Encoding (BPE) hoặc WordPiece
Loại bỏ các từ hiếm gặp khỏi văn bản
Chọn đáp án C
Trong quá trình huấn luyện mô hình ngôn ngữ, "Masked Language Modeling" (mô hình hóa ngôn ngữ che mặt nạ) là gì và nó được sử dụng trong mô hình nào nổi tiếng?
Một phương pháp huấn luyện mà trong đó mô hình được yêu cầu dự đoán các từ bị che ngẫu nhiên trong câu; được sử dụng trong BERT
Một phương pháp để tăng cường dữ liệu huấn luyện bằng cách tạo ra các biến thể của câu gốc
Một kỹ thuật để giảm thiểu overfitting bằng cách che giấu một số kết nối nơ-ron
Một phương pháp để đánh giá hiệu suất của mô hình ngôn ngữ bằng cách che giấu một phần văn bản và xem mô hình có thể khôi phục nó tốt đến đâu
Chọn đáp án A
Để xây dựng một hệ thống hỏi đáp tự động (Question Answering system), nhiệm vụ NLP nào sau đây là quan trọng để trích xuất thông tin chính xác từ văn bản cho trước để trả lời câu hỏi?
Phân tích tình cảm
Trích xuất thông tin (Information Extraction)
Sinh văn bản
Dịch máy
Chọn đáp án B
So sánh mô hình Word2Vec và GloVe trong việc tạo word embeddings. Điểm khác biệt chính giữa hai mô hình này là gì?
Word2Vec sử dụng ma trận đồng xuất hiện toàn cục, trong khi GloVe sử dụng cửa sổ trượt
GloVe dựa trên mạng nơ-ron, còn Word2Vec dựa trên phân tích ma trận
Word2Vec chỉ học được ngữ nghĩa, còn GloVe học được cả ngữ nghĩa và cú pháp
Word2Vec dự đoán ngữ cảnh từ từ trung tâm hoặc ngược lại, trong khi GloVe trực tiếp học các vectơ từ dựa trên ma trận đồng xuất hiện toàn cục
Chọn đáp án D
Trong ngữ cảnh NLP, "zero-shot learning" (học không cú nhảy) có nghĩa là gì?
Mô hình được huấn luyện trên dữ liệu tổng hợp
Mô hình có thể học từ rất ít dữ liệu huấn luyện
Mô hình có khả năng thực hiện nhiệm vụ hoặc phân loại các lớp mà nó chưa từng được thấy trong quá trình huấn luyện
Mô hình có thể học mà không cần bất kỳ dữ liệu huấn luyện nào
Chọn đáp án C
Ứng dụng nào sau đây KHÔNG phải là ứng dụng phổ biến của Xử lý ngôn ngữ tự nhiên (NLP)?
Trợ lý ảo (ví dụ: Siri, Alexa)
Dịch máy (Google Translate)
Phân loại thư rác
Phân tích thành phần hóa học của hợp chất
Chọn đáp án D
Để đánh giá chất lượng của một hệ thống tóm tắt văn bản tự động, thước đo ROUGE (Recall-Oriented Understudy for Gisting Evaluation) tập trung vào điều gì?
Độ chính xác của các thông tin trong bản tóm tắt
Mức độ bao phủ thông tin quan trọng từ văn bản gốc trong bản tóm tắt (Recall)
Tính trôi chảy và dễ đọc của bản tóm tắt
Thời gian cần thiết để hệ thống tạo ra bản tóm tắt
Chọn đáp án B
Trong quy trình NLP, bước nào sau đây thường được thực hiện ĐẦU TIÊN?
Thu thập và tiền xử lý dữ liệu văn bản
Huấn luyện mô hình học máy
Đánh giá mô hình
Triển khai mô hình
Chọn đáp án A
"Stop words" (từ dừng) là gì và tại sao chúng thường được loại bỏ trong tiền xử lý văn bản?
Các từ mang tính xúc phạm hoặc không phù hợp
Các từ hiếm gặp và ít quan trọng
Các từ xuất hiện thường xuyên nhưng ít mang ý nghĩa trong ngữ cảnh cụ thể (ví dụ: "là", "và", "của"); loại bỏ để giảm nhiễu và tập trung vào các từ khóa quan trọng
Các từ có nhiều nghĩa khác nhau, gây khó khăn cho việc phân tích
Chọn đáp án C
Để cải thiện hiệu suất của mô hình NLP trên các ngôn ngữ khác nhau, kỹ thuật "Cross-lingual transfer learning" (học chuyển giao đa ngôn ngữ) được sử dụng như thế nào?
Dịch dữ liệu huấn luyện sang nhiều ngôn ngữ khác nhau
Tận dụng kiến thức học được từ một ngôn ngữ (thường là ngôn ngữ giàu tài nguyên) để cải thiện hiệu suất trên các ngôn ngữ khác (đặc biệt là ngôn ngữ nghèo tài nguyên)
Huấn luyện mô hình trên dữ liệu đa ngôn ngữ cùng một lúc
Sử dụng các mô hình ngôn ngữ đa ngôn ngữ được đào tạo trước
Chọn đáp án B
Xét một ứng dụng phân tích đánh giá sản phẩm. Nếu mô hình phân tích tình cảm dự đoán một đánh giá là "tích cực", nhưng thực tế đánh giá đó là "tiêu cực", đây được gọi là lỗi gì?
Lỗi loại 1 (Type I error)
Độ lệch (Bias)
Phương sai (Variance)
Sai âm tính (False Negative) - mô hình bỏ sót trường hợp tích cực (trong ngữ cảnh đánh giá, "tích cực" có thể hiểu là dự đoán tích cực, nhưng thực tế là tiêu cực, vậy là bỏ sót tiêu cực, nhưng theo chuẩn sai âm tính là bỏ sót tích cực, câu này cần diễn đạt lại. -> Sai dương tính (False Positive): Mô hình báo đúng là tích cực, nhưng thực tế là tiêu cực.)
Chọn đáp án D
Trong lĩnh vực đối thoại tự động, "Entity recognition" (nhận dạng thực thể) giúp chatbot hiểu người dùng như thế nào?
Bằng cách xác định các thông tin quan trọng mà người dùng đề cập, như tên sản phẩm, địa điểm, thời gian, v.v.
Bằng cách phân tích cảm xúc của người dùng trong câu hỏi
Bằng cách dịch câu hỏi của người dùng sang ngôn ngữ máy
Bằng cách tóm tắt câu hỏi của người dùng
Chọn đáp án A
Để xử lý văn bản tiếng Việt, thư viện Python nào sau đây cung cấp các công cụ chuyên biệt và hiệu quả?
NLTK
spaCy
underthesea
Stanford CoreNLP
Chọn đáp án C
"Contextual word embeddings" (word embeddings theo ngữ cảnh), như ELMo và BERT, khác biệt so với "static word embeddings" (word embeddings tĩnh), như Word2Vec và GloVe, như thế nào?
Static word embeddings có kích thước cố định, trong khi contextual word embeddings thay đổi kích thước tùy theo ngữ cảnh
Contextual word embeddings tạo ra các biểu diễn khác nhau cho cùng một từ dựa trên ngữ cảnh xuất hiện của nó trong câu, trong khi static word embeddings tạo ra một biểu diễn duy nhất cho mỗi từ
Static word embeddings được huấn luyện trên dữ liệu lớn hơn contextual word embeddings
Contextual word embeddings chỉ phù hợp với các ngôn ngữ có ngữ pháp phức tạp
Chọn đáp án B
Trong quá trình phát triển ứng dụng NLP, vấn đề "thiên kiến dữ liệu" (data bias) có thể gây ra hậu quả gì?
Giảm độ chính xác của mô hình trên dữ liệu huấn luyện
Tăng tốc độ huấn luyện mô hình
Mô hình có thể đưa ra các dự đoán không công bằng hoặc phân biệt đối xử đối với một số nhóm người nhất định do dữ liệu huấn luyện không đại diện hoặc phản ánh các định kiến xã hội
Mô hình trở nên khó diễn giải hơn
Chọn đáp án C