300+ câu Trắc nghiệm Học máy cơ bản có đáp án - Phần 12
25 câu hỏi
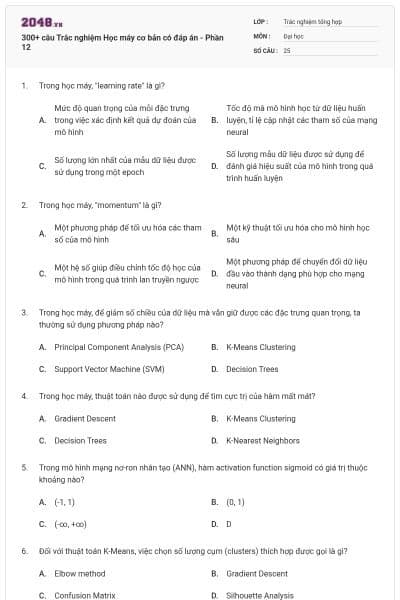
Mức độ quan trọng của mỗi đặc trưng trong việc xác định kết quả dự đoán của mô hình
Tốc độ mà mô hình học từ dữ liệu huấn luyện, tỉ lệ cập nhật các tham số của mạng neural
Số lượng lớn nhất của mẫu dữ liệu được sử dụng trong một epoch
Số lượng mẫu dữ liệu được sử dụng để đánh giá hiệu suất của mô hình trong quá trình huấn luyện
Chọn đáp án B
Một phương pháp để tối ưu hóa các tham số của mô hình
Một kỹ thuật tối ưu hóa cho mô hình học sâu
Một hệ số giúp điều chỉnh tốc độ học của mô hình trong quá trình lan truyền ngược
Một phương pháp để chuyển đổi dữ liệu đầu vào thành dạng phù hợp cho mạng neural
Chọn đáp án A
Principal Component Analysis (PCA)
K-Means Clustering
Support Vector Machine (SVM)
Decision Trees
Chọn đáp án A
Gradient Descent
K-Means Clustering
Decision Trees
K-Nearest Neighbors
Chọn đáp án A
(-1, 1)
(0, 1)
(-∞, +∞)
D
Chọn đáp án B
Elbow method
Gradient Descent
Confusion Matrix
Silhouette Analysis
Chọn đáp án A
Bằng cách giải phương trình đạo hàm của hàm mất mát
Bằng cách chia tổng của đầu ra cho tổng của đầu vào
Bằng cách tối ưu hàm mất mát bằng Gradient Descent
Bằng cách tính đạo hàm riêng của từng biến đầu vào
Chọn đáp án A
R² Score
Mean Absolute Error (MAE)
Confusion Matrix
Root Mean Squared Error (RMSE)
Chọn đáp án C
Phân loại
Hồi quy
Gom cụm
Phân tích dữ liệu thô
Chọn đáp án C

Học thông minh hơn mỗi ngày
Xem toàn bộ 25 câu hỏi và nhiều hơn nữa với tài khoản miễn phí
Principal Component Analysis (PCA)
Linear Discriminant Analysis (LDA)
Support Vector Machine (SVM)
Naive Bayes Classifier
Chọn đáp án A
Mô hình phản ứng quá mức với dữ liệu huấn luyện
Mô hình không đủ phức tạp để hiểu dữ liệu
Mô hình không thể học từ dữ liệu
Mô hình không thể tổng quát hóa từ dữ liệu
Chọn đáp án A
Tầng input
Tầng hidden
Tầng output
Tầng convolutional
Chọn đáp án C
Tăng số lượng epoch
Sử dụng learning rate lớn
Thêm dữ liệu huấn luyện
Giảm số lượng epoch
Chọn đáp án A
Accuracy, Precision, Recall
Mean Squared Error, Root Mean Squared Error
Mean Absolute Error, R-squared
F1-score, ROC-AUC
Chọn đáp án A
TensorFlow
Scikit-learn
Pandas
Matplotlib
Chọn đáp án C
Random Forest
Gradient Descent
K-means Clustering
Naive Bayes
Chọn đáp án B
Số lượng cụm cần phải xác định trước
Số lượng cụm được xác định dựa trên dữ liệu đầu vào
Không cần quan tâm đến số lượng cụm
Số lượng cụm được xác định bởi các tham số ngẫu nhiên
Chọn đáp án A
comp()
eq()
equal()
ne()
Chọn đáp án B
Sử dụng hàm static()
Sử dụng chỉ dẫn @staticmethod
Sử dụng chỉ dẫn @classmethod
Python không có phương thức tĩnh
Chọn đáp án B
numpy.nan_median()
numpy.median()
numpy.mediannan()
numpy.nanmedian()
Chọn đáp án D
3
92
89
Error
Chọn đáp án B
1 và 3
2 và 3
3
1 và 2
Chọn đáp án A
0.7
Lớn hơn hoặc bằng 70%
Luôn lớn hơn 70%
Có thể dưới 70%
Chọn đáp án D
ReLU
Sigmoid
Tanh
Không có trong các phương án trên
Chọn đáp án B
ReLU
LeakyReLU
SELU
ELU
Chọn đáp án A
Bạn có thích hoạt động này không?
Hãy lưu hoặc chia sẻ nội dung này đến mọi người.
Gợi ý cho bạn

Ý tưởng của bạn, bài học của bạn
Tự thiết kế đề thi, bài giảng hoặc flashcard theo cách riêng.
Học liệu phổ biến Trắc nghiệm tổng hợp
Trắc nghiệm tổng hợp
Bài tập vừa sức, đúng lớp
Chọn nội dung phù hợp và tạo hoạt động cho lớp của bạn.