
200+ câu Trắc nghiệm tổng hợp Data mining có đáp án
203 câu hỏi
Là một quy trình tìm kiếm, phát hiện các tri thức mới, tiềm ẩn, hữu dụng trong cơ sở dữ liệu lớn
Khai phá dữ liệu
Khai khoáng dữ liệu
Tìm kiếm thông tin trên Internet
a là đáp án đúng
Khai phá dữ liệu hoặc Khai thác dữ liệu
Khai phá luật kết hợp
Khai phá tập mục thường xuyên
Khai phá tri thức từ dữ liệu lớn
a là đáp án đúng
Trích chọn các mẫu hoặc tri thức hấp dẫn (không tầm thường, ẩn, chưa biết và hữu dụng tiềm năng) từ tập dữ liệu lớn
Khai phá dữ liệu
Khai thác dữ liệu
Tìm kiếm dữ liệu
a là đáp án đúng
Data Mining là một bước trong quá trình khai phá tri thức-KDD
Thuật ngữ Data Mining đồng nghĩa với thuật ngữ Knowledge Discovery from Databases
Data Mining là quá trình tìm kiếm thông tin có ích trên Internet
Tiền xử lí dữ liệu là qua trình tìm kiếm thông tin có ích từ cơ sở dữ liệu lớn
a là đáp án đúng
Hệ quản trị CSDL SQL Server
Hệ quản trị CSDL Access
Hệ quản trị CSDL Foxpro
Microsoft Word 2010
a là đáp án đúng
Data Preprocessing Khoa CNTT – Data Mining 1
Data Processing
Preprocessing in Database
Data Process
a là đáp án đúng
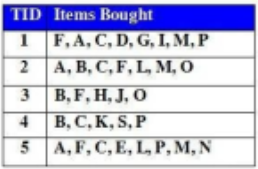
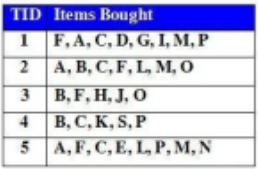
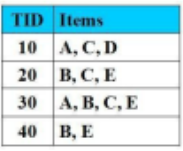
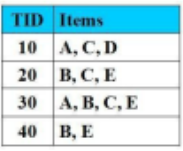
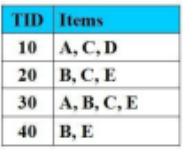
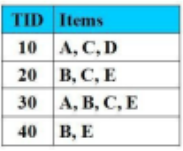
Cho CSDL Giao tác như hình vẽ, Số lượng giao dịch trong cơ sở dữ liệu là:
5
16
6
10
a là đáp án đúng
3 (60%)
4 (80%)
5 (100%)
2 (40%)
a là đáp án đúng
Tốn nhiều bộ nhớ và thời gian. Không thích hợp với các mẫu lớn. Chi phí để duyệt CSDL nhiều.
Không tìm được các tập thường xuyên
Kết quả của thuật toán không ứng dụng được trong các bài toán thực tế
Thuật toán quá phức tạp, khó hiểu
a là đáp án đúng
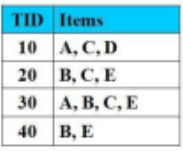
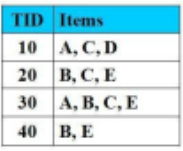
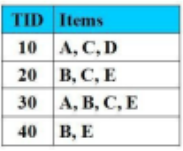
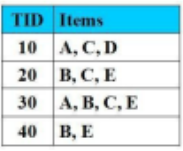
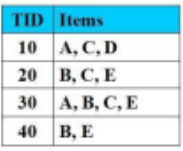
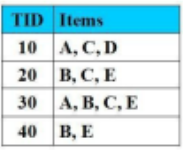
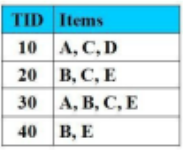
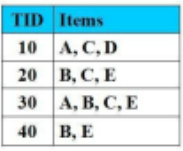
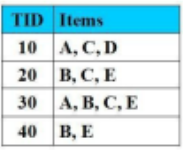
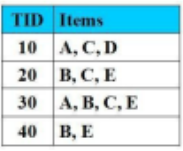
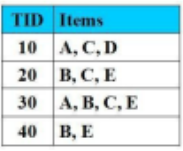
Cho CSDL giao dịch như hình vẽ với Min_Support = 2 (50%). Tập nào là tập mục thường xuyên thỏa Min_support:
{A,C}
{D}
{A,D}
{B, C, D}
a là đáp án đúng
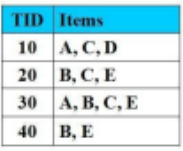
{A,C,D}
{A,E}
{A, C}
{B,E}
a là đáp án đúng
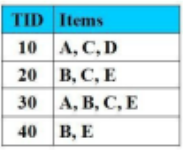
{D}
{A,E}
{A, C}
{B,E}
a là đáp án đúng
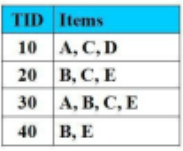
{D}
{A}
{B}
{A}, {D}
d là đáp án đúng
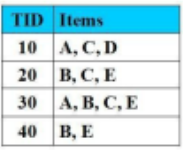
{B, D}
{A, E}
{A, C}
{B, E}
a là đáp án đúng
Không có tập nào
{A, E}
{A, C, D}
{B, C, D}
a là đáp án đúng
A-->C
A-->D
A--> E
AB-->C
a là đáp án đúng
B-->E
A-->D
A--> E
AB-->C
a là đáp án đúng
A-->C
A-->D
A--> E
AB-->C
a là đáp án đúng
A-->C
A-->D
AD--> E
AB-->C
a là đáp án đúng
A--> B, B--> A, không tính luật AB --> và --> AB
A-->B, B--> A, A--> và --> B
A--> B
B--> A
a là đáp án đúng
2 đường đi
1 đường đi
3 đường đi
4 đường đi
a là đáp án đúng
2 đường đi
1 đường đi
3 đường đi
4 đường đi
a là đáp án đúng
Tìm các tập mục thường xuyên
Tìm các luật kết hợp
Tìm các tập mục có k - item
Thực hiện công việc khác
a là đáp án đúng
Chia các đối tượng thành từng lớp để giảng dạy
Phân lớp dựa trên Cây quyết định
Phân lớp dựa trên xác suất Bayes
Phân lớp dựa trên Mạng Nơron
a là đáp án đúng
3 nhánh
2 nhánh
Nhiều nhánh
Phải biết kết luận C có bao nhiêu giá trị thì mới phân nhánh được
a là đáp án đúng
n bảng con
2 bảng con
không phải chia
Thành nhiều bảng tùy theo giá trị của n
a là đáp án đúng
0.35
3.5
0.015
Giá trị khác
a là đáp án đúng
Phân cụm dữ liệu(Data Clustering) hay phân cụm, cũng có thể gọi là phân tích cụm là quá trình chia một tập các đối tượng thực thể hay trừu tượng thành nhóm các đối tượng sao cho các phần tử trong cùng một nhóm thì có mức độ tương tự nhau hơn là giữa các phần tử của nhóm này với các phần tử của nhóm khác.
Phân cụm dữ liệu(Data Clustering) hay phân cụm, cũng có thể gọi là phân tích cụm là qúa trình chia một tập các đối tượng thực thể hay trừu tượng thành nhóm các đối tượng sao cho các phần tử khác nhóm thì có mức độ tương tự nhau hơn là giữa các phần tử trong cùng một nhóm.
Phân cụm dữ liệu(Data Clustering) hay phân cụm, cũng có thể gọi là phân tích cụm là quá trình chia một tập các đối tượng thực thể hay trừu tượng thành nhóm các đối tượng sao dễ sử dụng nhất.
Phân cụm dữ liệu(Data Clustering) hay phân cụm, cũng có thể gọi là phân tích cụm là quá trình chia các đối tượng thành từng nhóm sau cho số nhóm là ít nhất.
a là đáp án đúng
Data Clustering
Data Classification
Association Rule
Data Mining
a là đáp án đúng
Data Mining
Data Clustering
Data Classification
Association Rule
a là đáp án đúng
Data Classification
Data Clustering
Data Mining
Association Rule
a là đáp án đúng
1 cách
0 cách
2 cách
N cách
a là đáp án đúng
0 cách
m cách
2 cách
N cách
a là đáp án đúng
Rất nhiều
Chỉ có 3 thuật toán Liên kết đơn, liên kết đầy đủ, k-mean
Chỉ có 2 thuật toán Liên kết đơn và liên kết đầy đủ
Chỉ có 2 thuật toán Liên kết đơn và k-mean
a là đáp án đúng
Chọn ngẫu nhiên
Chọn k phần tử nằm ở tâm
Chọn k các phần tử có giá trị nhỏ nhất
Chọn k phần tử có giá trị bằng giá trị trung bình của các phần tử trong tập dữ liệu
a là đáp án đúng
k<=N
k=N
k>N
k khác N
a là đáp án đúng
Trích chọn dữ liệu, tiền xử lý dữ liệu, biến đổi dữ liệu, khai phá dữ liệu, đánh giá và biểu diễn tri thức
Tiền xử lý dữ liệu, biến đổi dữ liệu, khai phá dữ liệu, đánh giá và biểu diễn tri thức
Trích chọn dữ liệu, tiền xử lý dữ liệu, biến đổi dữ liệu, khai phá dữ liệu, khai phá luật kết hợp
Tiền xử lý dữ liệu, phân lớp, phân cụm, đánh giá và biểu diễn tri thức
a là đáp án đúng
Đặc trưng danh nghĩa, đặc trưng theo thứ tự, đặc trưng đo theo khoảng, đặc trưng đo theo tỷ lệ
Đặc trưng danh nghĩa, đặc trưng theo thứ tự, đặc trưng đo theo khoảng, đặc trưng theo khối lượng
Đặc trưng danh nghĩa, đặc trưng theo thứ tự, đặc trưng đo theo khoảng, đặc trưng theo chiều dài
Đặc trưng theo thứ tự, đặc trưng đo theo khoảng, đặc trưng đo theo tỷ lệ
a là đáp án đúng
Khai phá luật kết hợp, phân loại, phân cụm, hồi qui...
Khai phá luật kết hợp, xây dựng máy tìm kiếm...
Web mining, Text mining, mạng nơron…
Bài toán nhận dạng, bài toán tìm kiếm thông tin, bài toán lựa chọn đặc trưng...
a là đáp án đúng
Dữ liệu quá lớn, dữ liệu bị thiếu hoặc nhiễu, sự phức tạp của dữ liệu, dữ liệu thường xuyên thay đổi...
Trình độ của con người còn hạn chế, dữ liệu không được lưu trữ tập trung...
Dữ liệu quá lớn, máy khai phá dữ liệu có tốc độ hạn chế...
Tốc độ xử lý của máy tính còn hạn chế, dữ liệu thường xuyên thay đổi...
a là đáp án đúng
Machine Learning, Visualization, Statistics, Databases…
Machine Learning, Programming, Statistics, Databases…
Machine Learning, Visualization, Statistics, BioInfomatics…
Support Vector Machine, Clustering, Statistics, Databases…
a là đáp án đúng
Cung cấp hỗ trợ ra quyết định, dự báo, khái quát dữ liệu...
Tìm kiếm các quy luật, tìm kiếm các cụm và phân loại dữ liệu
Tìm kiếm nhanh thông tin, thống kê dữ liệu, chọn đặc trưng của dữ liệu...
Tạo ra cơ sở tri thức mới, hỗ trợ dự báo thời tiết, dự báo động đất, dự báo sóng thần...
a là đáp án đúng
Cung cấp hỗ trợ ra quyết định, dự báo, khái quát dữ liệu...
Tìm kiếm các quy luật, tìm kiếm các cụm và phân loại dữ liệu
Tìm kiếm nhanh thông tin, thống kê dữ liệu, chọn đặc trưng của dữ liệu...
Tạo ra cơ sở tri thức mới, hỗ trợ dự báo thời tiết, dự báo động đất, dự báo sóng thần...
a là đáp án đúng
Loại bỏ nhiễu và dữ liệu không nhất quán
Tìm kiếm dữ liệu có ích
Tìm kiếm dữ liệu có ích trong cơ sở dữ liệu lớn
Tổ hợp nhiều nguồn dữ liệu khác nhau
a là đáp án đúng
Phân tích và quản lý thị trường, Quản lý và phân tích rủi ro, Quản lý và phân tích các sai hỏng, Khai thác Web, Khai thác văn bản (text mining)…
Tìm kiếm văn bản, Tìm kiếm hình ảnh, Tìm kiếm tri thức mới trên Internet...
Phân tích tâm lí khách hàng, Hỗ trợ kinh doanh, tối ưu hóa phần cứng máy tính...
Phân tích thị trường chứng khoán, bất động sản, tìm kiếm dữ liệu bằng các máy tìm kiếm...
a là đáp án đúng
Quan hệ, Giao tác, Hướng đối tượng, Không gian, Thời gian, Text, XML, Multi media, WWW, …
Text, XML, Multi-media, WWW, …
Cơ sở dữ liệu khách hàng, cơ sở dữ liệu nghiên cứu không gian, cơ sở dữ liệu trong ngân hàng, cơ sở dữ liệu thống kê…
Cơ sở dữ liệu tuyển sinh đại học, cơ sở dữ liệu dự báo thời tiết, cơ sở dữ liệu thống kê dân số…
a là đáp án đúng
Big data nói đến các tập dữ liệu rất lớn và phức tạp tới mức các kỹ thuật IT truyền thống không xử lí nổi.
Dữ liệu rất lớn
Dữ liệu được tích hợp từ nhiều nguồn khác nhau
Dữ liệu khổng lồ trên Internet
a là đáp án đúng
Giải quyết các bài toán sinh học bằng việc sử dụng các phương pháp của khoa học tính toán
Sinh học phân tử
Tìm kiếm dữ liệu mới từ sinh học
Khai thác các thông tin có ích trong lĩnh vực y học
a là đáp án đúng
Data Mining là một bước quan trọng trong quá trình khai phá tri thức từ dữ liệu – KDD
Tiền xử lí dữ liệu là chọn ra các đặc trưng tiêu biểu trong tập dữ liệu lớn
Mọi dữ liệu đều có thể tìm kiếm được bằng máy tìm kiếm của Google
Data Mining là công cụ giúp các lập trình viên dễ dàng tìm kiếm thông tin hơn
a là đáp án đúng
Điền giá trị thiếu, làm trơn dữ liệu nhiễu, định danh hoặc xóa ngoại lai, và khử tính không nhất quán
Chuẩn hóa và tổng hợp
Bước cuối cùng trong quá trình Data Mining
Tích hợp CSDL, khối dữ liệu hoặc tập tin phức
a là đáp án đúng
Xử lý giá trị thiếu, Dữ liệu nhiễu: định danh ngoại lai và làm trơn, Chỉnh sửa dữ liệu không nhất quán, Giải quyết tính dư thừa tạo ra sau tích hợp dữ liệu.
Làm trơn theo biên, phương pháp đóng thùng, điền giá trị thiếu, Giải quyết tính dư thừa tạo ra sau tích hợp dữ liệu.
Phân cụm, phân lớp, hồi quy, biểu diễn dữ liệu.
Phân cụm, tìm luật kết hợp, tìm kiếm đặc trưng
a là đáp án đúng
2^n -1
2^n
Vô số tập con
n^2
a là đáp án đúng
Bỏ qua bản ghi có dữ liệu bị thiếu, điền giá trị thiếu bằng tay, điền giá trị tự động
Loại bỏ dựa trên quan sát, loại bỏ khi lựa chọn đặc trưng
Loại bỏ toàn bộ dữ liệu bị nhiễu và thay thế bằng tập dữ liệu mới, lựa chọn các đặc trưng quan trọng
Sử dụng các thuật toán phân lớp, phân cụm, tìm luật kết hợp
a là đáp án đúng
5
6
9
Giá trị khác
a là đáp án đúng
Các bản ghi có dữ liệu bị thiếu chiếm tỷ lệ nhỏ trong toàn bộ dữ liệu
Các bản ghi có dữ liệu bị thiếu chiếm tỷ lệ lớn trong toàn bộ dữ liệu
Có thể bỏ qua tất cả các bản ghi bị thiếu
Không thể bỏ qua, phải tìm các giá trị để điền vào các bản ghi bị thiếu
a là đáp án đúng
Support(X)=Số lượng giao dịch hỗ trợ X / N
Support(X)=Số lượng giao dịch hỗ trợ X
Support(X)=Số lượng giao dịch hỗ trợ X / N * |I|, trong đó |I| là tổng số mục trong CSDL
Support(X)=Số lượng giao dịch hỗ trợ X *100%
a là đáp án đúng
Confidence(X?Y)=Số lượng giao dịch hỗ trợ cả X và Y / Số lượng giao dịch hỗ trợ X
Confidence(X?Y)=Số lượng giao dịch hỗ trợ X / Số lượng giao dịch hỗ trợ Y
Confidence(X?Y)=Số lượng giao dịch hỗ trợ cả X và Y / Số lượng giao dịch hỗ trợ Y
Confidence(X?Y)=Số lượng giao dịch hỗ trợ cả X và Y /N
a là đáp án đúng
Support(X?Y)=Số lượng giao dịch hỗ trợ cả X và Y / N
Support(X?Y)=Số lượng giao dịch hỗ trợ cả X và Y / Số lượng giao dịch hỗ trợ Y
Support(X?Y)=Số lượng giao dịch hỗ trợ cả X và Y / Số lượng giao dịch hỗ trợ X
Support(X?Y)=Số lượng giao dịch hỗ trợ cả X / Số lượng giao dịch hỗ trợ Y
a là đáp án đúng
Support(X)>=Min_Supp
Support(X)<=Min_Supp
Support(X)=Min_Supp
Support(X: Min_Supp/N
a là đáp án đúng
Support(X?Y)>=Min_Supp, Confidence(X?Y)>=Min_Conf
Support(X?Y)=Min_Supp, Confidence(X?Y)=Min_Conf
Support(X?Y)<Min_Supp, Confidence(X?Y)<Min_Conf
Support(X?Y)>Min_Supp, Confidence(X?Y)=Min_Conf
a là đáp án đúng
2^N - 1
2^N
N
Vô số tập mục
a là đáp án đúng
AB-->C
A-->D
ABD-->C
D-->C
a là đáp án đúng
Conference(AB-->C) >= Conference(A-->BC)
Conference(AB-->C) <= Conference(A-->BC)
Conference(AB-->C: Conference(A-->BC)
Chưa kết luận được AB-->C có thỏa độ hỗ trợ tối tiểu và độ tin cậy tối thiểu hay không
a là đáp án đúng
Support(ABC) < Support(ABCD)
Support(ABC) >= Support(ABCD)
Support(AB) >= Support(ABC)
Support(AB) <= Support(A)
a là đáp án đúng
Confidence(AC--> B) >= Confidence(A--> BC)
Confidence(AC--> B: Confidence(A--> BC)
Confidence(A--> AB)>=Confidence(AC-->C)
Confidence(AB--> C) >= Confidence(AC--> B)
a là đáp án đúng
{A, B, C}, {A, B, D}
{A, B, C}, {A, B, D}, {A, B, C, D}
{A, B, C}, {B, C, D}
{A, B, C}, {C, B, D}
a là đáp án đúng
Tạo ra từ tập chứa k-1 item bằng cách ghép 2 tập k-1 item với nhau với điều kiện là 2 tập k-1 item này phải có chung nhau k-2 item
Tổ hợp k item từ các item có trong cơ sở dữ liệu giao dịch.
Lấy ngẫu nhiên k item sau đó ghép lại với nhau.
Sinh mọi tập con có k item từ các item có trong cơ sở dữ liệu giao dịch
a là đáp án đúng
abc và abd
abc và ade
abc và ace
abd và ade
a là đáp án đúng
FP-Tree là cây nhị phân
FP-Tree là cây tổng quát
Khi thêm 1 giao dịch vào FP-Tree đều phải thêm bắt đầu từ gốc.
Bảng đầu mục – Header Table dùng để lưu 3 thông tin: Tên item, Số lượng item đó xuất hiện trong CSDL giao dịch và Con trỏ dùng để trỏ đến nút cùng tên được sinh ra đầu tiên
a là đáp án đúng
Là mô hình toán học mô phỏng theo mạng Nơron sinh học để giải quyết các bài toán
Là mạng máy tính có tốc độ truyền thông cao
Là mạng Nơron do con người tạo ra
Là một phương pháp để phân loại Gen của các loài sinh vật
a là đáp án đúng
Gain(C,A)=Entropy(C)-Entropy(A)
Gain(C,A)=Entropy(C)+Entropy(A)
Gain(C,A)=Entropy(A)-Entropy(C)
Gain(C,A)=Entropy(C)*Entropy(A)
a là đáp án đúng
Thuật toán Quilan chọn ngẫu nhiên 1 thuộc tính để làm gốc cây quyết định
Độ phân biệt (độ lộn xộn) của một thuộc tính với kết luận C cao nhất thì Entropy của nó thấp nhất
Thuật toán học khái niệm CLS chọn ngẫu nhiên 1 thuộc tính để làm gốc cây quyết định
Entropy là một số biến thiên trong đoạn [0,1].
a là đáp án đúng
Số kết luận ‘Yes’=Số kết luận ‘No’
Số kết luận ‘Yes’ =0
Số kết luận ‘No’ =0
Không kết luận được điều gì
a là đáp án đúng
Số kết luận ‘Yes’=0 hoặc Số kết luận ‘No’
Số kết luận ‘Yes’ = Số kết luận ‘No’
Số kết luận ‘No’ =1 và Số kết luận ‘Yes’ = 1
Không kết luận được điều gì
a là đáp án đúng
Thuộc tính có độ phân biệt cao nhất
Thuộc tính có độ phân biệt thấp nhất
Thuộc tính có Entropy cao nhất
Chọn ngẫu nhiên
a là đáp án đúng
Chọn ngẫu nhiên
Thuộc tính có độ phân biệt thấp nhất
Thuộc tính có Entropy cao nhất
Thuộc tính có độ phân biệt cao nhất
a là đáp án đúng
[0 ; 1]
(0 ; 1)
Miền giá trị là tập số nguyên dương
Miền giá trị là tập số thực dương
a là đáp án đúng
Xây dựng cây quyết định
Tìm các luật
Tìm độ phân biệt của các thuộc tính
Giúp ta tìm ra 1 thuộc tính làm gốc cây quyết định
a là đáp án đúng
Đây là một độ đo chỉ ra mức độ tương tự hay không tương tự giữa hai vector đặc trưng
Độ đo giữa 2 phần tử bất kỳ
Khoảng cách giữa 2 phần tử trong không gian
Độ đo sử dụng trong Data Mining để phân cụm dữ liệu
a là đáp án đúng
Độ đo tương tự và độ đo không tương tự
Độ đo khoảng cách và độ đo tình cảm
Độ đo Ơclit và độ đo phi Ơclit
Độ đo tương tự và độ đo khoảng cách trong không gian 2 chiều
a là đáp án đúng
Độ đo không tương tự
Độ đo tương tự
Độ đo giữa 2 đối tượng cùng loại
Độ đo giữa 2 đối tượng khác loại
a là đáp án đúng
d=sqr(sqrt(x1-x2)+sqrt(y1-y2)) trong đó sqr là hàm bình phương, sqrt là hàm lấy căn.
d=sqr(sqrt(x1+x2)+sqrt(y1+y2)) trong đó sqr là hàm bình phương, sqrt là hàm lấy căn.
d=x1*x2+y1*y2
Công thức khác
a là đáp án đúng
d(A,B)=5
d(A,B)=3
d(A,B)=4
d(A,B)=1
a là đáp án đúng
mC= (x1+x2+...+xk)/k
mC= (x1+x2+...+xk)
mC= (x1+x2+...+xk)/N
mC= (x1+x2+...+xk)/k*N
a là đáp án đúng
Khoảng cách từ x đến tâm cụm C là nhỏ nhất
Khoảng cách từ x đến tâm cụm C là lớn nhất
Khoảng cách từ x đến tâm cụm C bằng 0
Khoảng cách từ x đến tâm cụm C bằng k
a là đáp án đúng
Tính lại tâm của các cụm
Tính khoảng cách giữa các phần tử trong cụm
Tìm một số phần tử đại diện của cụm
Trộn các cụm lại với nhau để số cụm sinh ra là ít nhất
a là đáp án đúng
C1={A, B} ; C2={C, D}
C1={A, C} ; C2={B, D}
C1={A, B, C} ; C2={D}
C1={A, B, D} ; C2={C}
a là đáp án đúng
C1={A, B, E} ; C2={C, D}
C1={A, C, E} ; C2={B, D}
C1={A, B, C} ; C2={D, E}
C1={A, B, D} ; C2={C, E}
a là đáp án đúng
mC = (2 ; 1)
mC = (2 ; 0)
mC = (2.5 ;1.5)
mC=(0 ; 0)
a là đáp án đúng
mC = (3 ; 2)
mC = (2 ; 3)
mC = (2.5 ;1.5)
mC=(6 ; 1)
a là đáp án đúng
Dạng hình cầu
Cụm dài và mảnh
Các cụm có các điểm phân bố ngẫu nhiên
Hình dạng bất kỳ
a là đáp án đúng
Thuật toán khó cài đặt
Không đảm bảo đạt được tối ưu toàn cục
Khó phát hiện các loại cụm có hình dạng phức tạp và nhất là các dạng cụm không lồi
Cần phải xác định trước số cụm k
a là đáp án đúng
Không thể gán (hoặc gán lại) từng điểm vào cụm khác
Số cụm sinh ra là k
Tùy theo yêu cầu của người dùng
Khi tất cả các phần tử đã được gán vào k cụm
a là đáp án đúng
Phụ thuộc vào thứ tự các phần tử đưa vào phân cụm
Cần phải xác định trước số cụm cần sinh ra
k-mean phù hợp với các cụm có dạng hình cầu
Vector được chọn làm tâm của mỗi cụm là vector trung bình của cụm đó
a là đáp án đúng
Một sơ đồ ngưỡng tương tự (hoặc không tương tự).
Một danh sách các cụm
Một cây nhị phân biểu diễn quá trình gom cụm
k cụm được sinh ra, với k cho trước
a là đáp án đúng
Thuật toán phân cụm phân cấp phụ thuộc vào trình tự đưa các phần tử vào phân cụm
Cắt sơ đồ ngưỡng tương tự hoặc không tương tự tại một ngưỡng nào đó, ta sẽ được danh sách các cụm
Single Linkage, Complete Linkage là 2 trường hợp đặc biệt của thuật toán phân cấp
Kết quả phân cụm phụ thuộc vào việc chọn đặc trưng, chọn độ đo gần gũi, chọn đại diện của cụm và chọn thuật toán phân cụm
a là đáp án đúng
Lựa chọn dữ liệu, tiền xử lí dữ liệu, chuyển dạng, khai phá dữ liệu, trình diễn dữ liệu
Lựa chọn dữ liệu, chuyển dạng, khai phá dữ liệu, tiền xử lí dữ liệu, trình diễn dữ liệu
Lựa chọn dữ liệu, khai phá dữ liệu, trình diễn dữ liệu tiền, xử lí dữ liệu
Lựa chọn dữ liệu, khai phá dữ liệu, trình diễn dữ liệu
a là đáp án đúng
Công nghệ phần cứng phát triển mạnh, năng lực số hóa của con người ngày càng cao, bùng nổ công nghệ mạng, tác nhân tạo mới dữ liệu ngày càng nhiều...
Khoa khọc kỹ thuật ngày càng tiến bộ, nguồn nhân lực ngành Công nghệ thông tin ngày càng đông, nhu cầu khai thác thông tin ngày càng nhiều...
Thông tin thu thập từ việc nghiên cứu các hành tinh, thông tin chống khủng bố, thông tin quảng cáo ngày càng nhiều...
Dữ liệu quảng cáo ngày càng nhiều, bùng nổ các mạng xã hội,...
a là đáp án đúng
Cách kết hợp dữ liệu tìm được từ các nguồn dữ liệu khác nhau
Tích hợp thông tin khách hàng phục vụ quá trình Data Mining
Phân chia dữ liệu phục vụ quá trình Data Mining
Là bước thực hiện sau khi đã tìm kiếm tri thức mới từ dữ liệu
a là đáp án đúng
Dữ liệu sau khi Tiền xử lí sẽ thành tri thức mới
Không có dữ liệu tốt, không thể có kết quả khai phá tốt
Phân lớn công việc xây dựng một kho dữ liệu là trích chọn, làm sạch và chuyển đổi dữ liệu —Bill Inmon
Dữ liệu có chất lượng cao nếu như phù hợp với mục đích sử dụng trong điều hành, ra quyết định, và lập kế hoạch.
a là đáp án đúng
Làm sạch dữ liệu, Tích hợp dữ liệu, Chuyển dạng dữ liệu, Rút gọn dữ liệu, Rời rạc dữ liệu
Làm sạch dữ liệu, Tích hợp dữ liệu, Chuyển dạng dữ liệu, Rời rạc dữ liệu
Phân lớp, Tìm luật kết hợp, Gom cụm
Lựa chọn đặc trưng, Tìm thuật toán để Khai phá dữ liệu
a là đáp án đúng
Phân hoạch cân bằng bề rộng Equal-width và Phân hoạch cân bằng theo chiều sâu Equal-depth
Xếp thùng theo chiều sâu và Xếp thùng làm trơn theo giá trị nhỏ nhất
Làm trơn theo giá trị lớn nhất và làm trơn theo giá trị nhỏ nhất
Làm trơn theo biên phải và làm trơn theo biên trái
a là đáp án đúng
Sắp xếp dữ liệu tăng dần và chia đều vào các thùng, sau đó sử dụng phương pháp làm trơn theo trung bình, theo biên, theo trung tuyến.
Chia đều dữ liệu vào các thùng, sau đó sử dụng phương pháp làm trơn theo trung bình, theo biên, theo trung tuyến.
Sắp xếp dữ liệu tăng dần và chia vào các thùng, mỗi thùng có số phần tử tùy ý, sau đó sử dụng phương pháp làm trơn theo trung bình, theo biên, theo trung tuyến.
Sắp xếp dữ liệu giảm dần và chia đều vào N thùng, loại bỏ các thùng không cần thiết
a là đáp án đúng
Bin 1: 4, 8, 9, 15; Bin 2: 21, 21, 24, 25; Bin 3: 26, 28, 29, 34
Bin 1: 4, 4, 4, 4; Bin 2: 21, 21, 21, 21; Bin 3: 26, 26, 26, 26
Bin 1: 4, 4, 4, 15; Bin 2: 21, 21, 25, 25; Bin 3: 26, 26, 26, 34
Bin 1: 15, 15, 15, 15; Bin 2: 23, 23, 23, 23; Bin 3: 29, 29, 29, 29
a là đáp án đúng
Bin 1: 9, 9, 9, 9; Bin 2: 23, 23, 23, 23; Bin 3: 29, 29, 29, 29
Bin 1: 4, 4, 4, 4; Bin 2: 21, 21, 21, 21; Bin 3: 26, 26, 26, 26
Bin 1: 4, 4, 4, 15; Bin 2: 21, 21, 25, 25; Bin 3: 26, 26, 26, 34
Bin 1: 15, 15, 15, 15; Bin 2: 23, 23, 23, 23; Bin 3: 29, 29, 29, 29
a là đáp án đúng
Bin 1: 4, 4, 4, 15; Bin 2: 21, 21, 25, 25; Bin 3: 26, 26, 26, 34
Bin 1: 4, 4, 4, 4; Bin 2: 21, 21, 21, 21; Bin 3: 26, 26, 26, 26
Bin 1: 9, 9, 9, 9; Bin 2: 23, 23, 23, 23; Bin 3: 29, 29, 29, 29
Bin 1: 15, 15, 15, 15; Bin 2: 23, 23, 23, 23; Bin 3: 29, 29, 29, 29
a là đáp án đúng
Chi miền giá trị thành N đoạn có độ dài như nhau nhau sẽ được xếp vào cùng 1 thùng
Chia miền xác định thành N đoạn ‘’đều nhau về số lượng’’ các đoạn có xấp xỉ số ví dụ mẫu.
Lựa chọn số phần tử ngẫu nhiên và xếp và N thùng
Các phần tử có giá trị như
a là đáp án đúng
Min-Max, z-Score, Tỷ lệ thập phân – decimal scale
2NF, 3NF, BCNF
Đưa về hệ đếm thập phân, Hệ nhị phân, hệ Hecxa
Chuẩn hóa về dữ liệu văn bản, hình ảnh, âm thanh
a là đáp án đúng
Tập hợp khối dữ liệu, Giảm đa chiều – loại bỏ thuộc tính không quan trọng, Nén dữ liệu, Giảm tính số hóa – dữ liệu thành mô hình, Rời rạc hóa và sinh cây khái niệm
Tìm kiếm thêm thông tin có ích, xây dựng cây quyết định, phân nhóm dữ liệu
Phân lớp dữ liệu, tìm đặc trưng của dữ liệu, loại bỏ nhiễu
Loại bỏ phần tử ngoại lai, tìm các dữ liệu quan trọng, đưa về mô hình toán học
a là đáp án đúng
0.716
0.800
0.500
Giá trị khác
a là đáp án đúng
5.0
8.0
9.0
Giá trị khác
- 0.986 đến 0.917
0.0 đến 1.0
0.0 đến 9.17
Giá trị khác
0.15
1.5
0.015
Giá trị khác
Chỉ áp dụng cho dữ liệu số và dùng khi số chiều vector lớn
Chỉ áp dụng cho dữ liệu văn bản và dùng khi số chiều vector lớn
áp dụng cho mọi loại dữ liệu
Tìm đặc trưng quan trọng của tập dữ liệu
Cho N vector dữ liệu k-chiều, tìm c (<= k) vector trực giao tốt nhất để trình diễn dữ liệu. Tập dữ liệu gốc được rút gọn thành N vector dữ liệu c chiều: c thành phần chính (chiều được rút gọn). Mỗi vector dữ liệu là tổ hợp tuyến tính của các vector thành phần chính.
Cho N vector dữ liệu k-chiều, tìm c (<= k) vector đại diện để trình diễn dữ liệu. Tập dữ liệu gốc được rút gọn thành N vector dữ liệu c chiều: c thành phần chính (chiều được rút gọn). Mỗi vector dữ liệu là tổ hợp tuyến tính của các vector thành phần chính.
Cho N vector dữ liệu k-chiều, tìm c (<= k) vector trực giao tốt nhất để trình diễn dữ liệu. Tập dữ liệu gốc được rút gọn thành N vector dữ liệu k chiều: k thành phần chính (chiều được rút gọn). Mỗi vector dữ liệu là tổ hợp tuyến tính của các vector thành phần chính.
Cho N vector dữ liệu k-chiều, tìm c (<= k) vector để trình diễn dữ liệu. Tập dữ liệu gốc được rút gọn thành 1 vector dữ liệu c chiều: c thành phần chính (chiều được rút gọn). Mỗi vector dữ liệu là tổ hợp tuyến tính của các vector thành phần chính.
Rút gọn số lượng giá trị của thuộc tính liên tục bằng cách chia miền giá trị của thuộc tính thành các đoạn. Nhãn đoạn sau đó được dùng để thay thế giá trị thực.
Đưa dữ liệu về dạng số nhị phân
Biểu diễn dữ liệu thành dạng dữ liệu không liên tục
Chuyển đổi dữ liệu sang dạng sóng điện từ
Conference(S’-->L-S) <= Conference(S-->L-S)
Conference(S’-->L-S: Conference(S-->L-S)
Conference(S’-->L-S) > Conference(S-->L-S)
Không so sánh được Conference(S’-->L-S) và Conference(S-->L-S)
Support(X)>=Support(Y)
Support(X)<=Support(Y)
Support(X) =Support(Y)
Không so sánh được Support(X) và Support(Y)
Support(X)>=Support(Y)
Support(X)<=Support(Y)
Support(X) =Support(Y)
Không so sánh được Support(X) và Support(Y)
Y không là tập mục thường xuyên
Y là tập mục thường xuyên
X là tập mục thường xuyên
Không thể kết luận được điều gì
Y là tập mục thường xuyên
Y không là tập mục thường xuyên
C là tập mục thường xuyên
X không là tập mục thường xuyên
Tập con của một tập mục thường xuyên KHÔNG là tập mục thường xuyên
Tập con của một tập mục thường xuyên là tập mục thường xuyên
Nếu luật kết hợp A-->BC thỏa mãn điều kiện của bài toán thì AB-->C cũng là luật kết hợp thỏa mãn điều kiện của bài toán
Cho tập mục X={X1, X2, …, Xn}. Nếu tất cả các mục Xi trong X đều không là tập mục thường xuyên thì mọi tập con Y của X cũng không là tập mục thường xuyên.
Y không là tập mục thường xuyên
Y là tập mục thường xuyên
X là tập mục thường xuyên
C không là tập mục thường xuyên
Y không là tập mục thường xuyên
Y là tập mục thường xuyên
X là tập mục thường xuyên
Tập X – Y là tập mục thường xuyên
Tạo ra các tập phổ biến (thường xuyên) có 1 item, rồi tiếp đến là 2 items, 3 items... cho đến khi chúng ta tạo ra tập phổ biến của mọi kích thước. Mỗi tập item được tạo ra phải được tính toán độ hỗ trợ và độ tin cậy. Tập k-item được tạo ra từ tập k-1 items. Tạo danh sách các item dự kiến của tập k-items bằng cách hợp từng đôi một tập k-1 items có trong danh sách.
Tạo ra các tập phổ biến (thường xuyên) có 1 item, rồi tiếp đến là 2 items, 3 items... cho đến khi chúng ta tạo ra tập phổ biến của mọi kích thước. Tập k item được tạo ra từ tập k-1 items. Tạo danh sách các item dự kiến của tập k-items bằng cách hợp từng đôi một tập k-1 items có trong danh sách. Loại bỏ các tập item không thỏa độ hỗ trợ và độ tin cậy
Tạo bảng chứa các item phổ biến, loại bỏ các item không phổ biến. Giả sử có k item là ứng viên. Tính các tập mục mà mỗi mục có số lượng phần tử là tổ hợp chập 1, 2, 3, … k của k item. Loại bỏ các item không thỏa mãn độ hỗ trợ và độ tin cậy.
Lần lượt tạo ra danh sách các item dự kiến của tập k-items bằng cách hợp từng đôi một tập k-1 items có trong danh sách. Loại bỏ các tập item không thỏa độ hỗ trợ và độ tin cậy.
2^k-2, không tính luật X và X
2^k không tính luật X và X
k luật
Vô số luật kết hợp
6 luật, không tính luật X và X
8 luật, không tính luật X và X
3 luật
1 luật
14 luật, không tính luật X và X
16 luật, không tính luật X
3 luật
1 luật
d(x,y)>0 ; d(x,y)=d(y,x) ; d(x,y) =0 ; d(x,y)<=d(x,z)+d(z,y)
d(x,y)>=0 ; d(x,y)<=d(x,z)+d(z,y)
d(x,y)>=0 ; d(x,y)=d(y,x) ; d(x,x) =0 ; d(x,y)<=d(x,z)+d(z,y)
d(x,y)>=0 ; d(x,x) =0 ; d(x,y)<=d(x,z)+d(z,y)
Đại diện điểm, đại diện siêu cầu
Đại diện siêu phẳng, đại diện điểm
Đại diện điểm, đại diện siêu phẳng và đại diện siêu cầu
Đại diện siêu cầu, đại siêu phẳng
S(N, m) = m.S(N, m) + S(N - 1, m - 1)
S(N, m) = N.S(N - 1, m) + S(N - 1, m - 1)
S(N, m) = m.S(N - 1, m) + S(N - 1, m - 1)
S(N, m) = S(N - 1, m) + m.S(N - 1, m - 1)
S(N,2) = 2^N - 1
S(N,2) = 2^(N-1)
S(N,2) = 2^(N-1) - 1
S(N,2) = 2^N
S(N,2) = 2^N - 1
S(N,2) = 2^(N-1)
S(N,2) = 2^(N-1) - 1
S(N,2) = 2^N
16 cách
15 cách
7 cách
1 cách
7 cách
32 cách
15 cách
1 cách
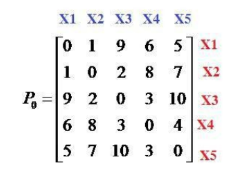
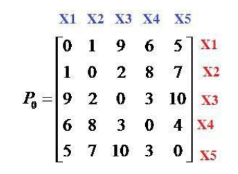
Cho tập X gồm N phần tử {x1, x2, …, xN}, mỗi phần tử là một vector. Ma trận không tương tự P(X) là ma trận cấp N N mà phần tử nằm ở vị trí (i, j) có giá trị là i*j
Cho tập X gồm N phần tử {x1, x2, …, xN}, mỗi phần tử là một vector. Ma trận không tương tự P(X) là ma trận cấp N N mà phần tử nằm ở vị trí (i, j) bằng 0
Cho tập X gồm N phần tử {x1, x2, …, xN}, mỗi phần tử là một vector. Ma trận không tương tự P(X) là ma trận cấp N N mà phần tử nằm ở vị trí (i, j) bằng độ không tương tự d(xi,xj) giữa hai vector xi và xj.
Cho tập X gồm N phần tử {x1, x2, …, xN}, mỗi phần tử là một vector. Ma trận không tương tự P(X) là ma trận cấp N N mà phần tử nằm trên đường chéo chính bằng 0, các phần tử khác có giá trị bất kỳ
Là ma trận đối xứng qua đường chéo chính
Là ma trận cho biết độ không tương tự giữa 2 phần tử bất kỳ
Các phần tử nằm trên đường chéo chính bằng có giá trị 0
Là ma trận mà các phần tử trên đường chéo chính bằng 1
Sơ đồ gần gũi là một sơ đồ xét mức độ gần gũi ở đó hai cụm được trộn với nhau tạo thành sơ đồ hình cây
Sơ đồ gần gũi là một sơ đồ xét mức độ gần gũi biểu diễn mối quan hệ giữa các phần tử trong quá trình phân cụm
Sơ đồ gần gũi là sơ đồ không tương tự
Sơ đồ gần gũi là một sơ đồ xét mức độ gần gũi ở đó hai cụm được trộn với nhau ở lần đầu tiên. Khi sử dụng độ đo không tương tự (tương tự), sơ đồ gần gũi được gọi là một sơ đồ không tương tự (tương tự).
O(n+k+t) trong đó n là số phần tử cần phân cụm, k là số cụm, t là số lần lặp
O(n^2) trong đó n là số phần tử cần phân cụm
O(n) trong đó n là số phần tử cần phân cụm
O(n*k*t) trong đó n là số phần tử cần phân cụm, k là số cụm, t là số lần lặp
Chọn 2 cụm gần nhau nhất Ci, Cj để trộn với nhau thành cụm Cp. Khoảng cách giữa cụm mới Cp và các cụm còn lại Cq là d(Cp,Cq)=Max{d(Ci,Cq); d(Cj,Cq)}
Chọn 2 cụm xa nhau nhất Ci, Cj để trộn với nhau thành cụm Cp. Khoảng cách giữa cụm mới Cp và các cụm còn lại Cq là d(Cp,Cq)=Min{d(Ci,Cq); d(Cj,Cq)}
Chọn 2 cụm xa nhau nhất Ci, Cj để trộn với nhau thành cụm Cp. Khoảng cách giữa
Chọn 2 cụm gần nhau nhất Ci, Cj để trộn với nhau thành cụm Cp. Khoảng cách giữa cụm mới Cp và các cụm còn lại Cq là d(Cp,Cq)=Min{d(Ci,Cq); d(Cj,Cq)} cụm mới Cp và các cụm còn lại Cq là d(Cp,Cq)=Max{d(Ci,Cq); d(Cj,Cq)}
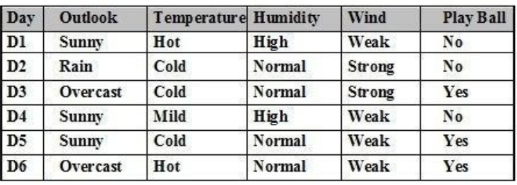
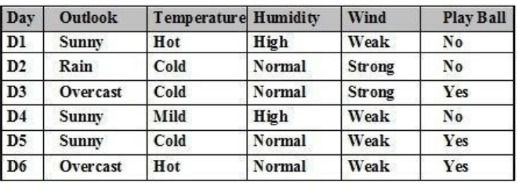
Cho tập ví dụ học như bảng. Có bao nhiêu thuộc tính để phân lớp ?
4 thuộc tính
3 thuộc tính
5 thuộc tính
6 thuộc tính
2 giá trị
3 giá trị
5 giá trị
1 giátrị
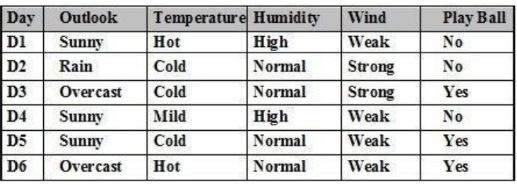
Outlook, Temperature, Humidity, Wind
Outlook, Temperature, Humidity, Wind, Play Ball
Day, Outlook, Temperature, Humidity, Wind
Day, Outlook, Temperature, Humidity, Wind, Play Ball
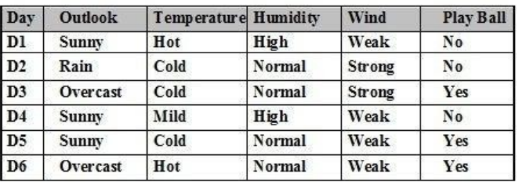
2 bảng
3 bảng
không cần chia
Tùy theo thuộc tính được chọn
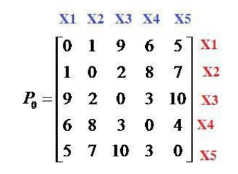
bằng 1
bằng 2
bằng 0
bằng 9
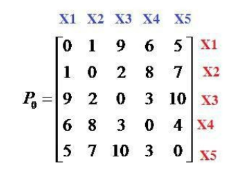
bằng 5
bằng 2
bằng 0
bằng 9
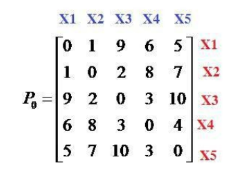
x1 và x2
x1 và x3
x2 và x3
x3 và x5
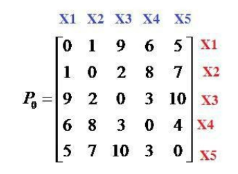
x1 và x2
x1 và x3
x2 và x3
x3 và x5
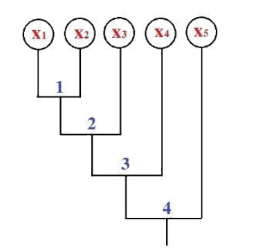
3 cụm
2 cụm
1 cụm
4 cụm
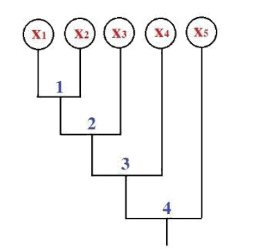
1 cụm
2 cụm
3 cụm
4 cụm
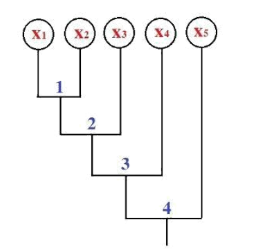
2 cụm
3 cụm
1 cụm
4 cụm
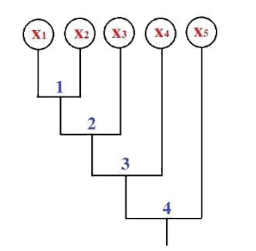
4 cụm
2 cụm
1 cụm
5 cụm
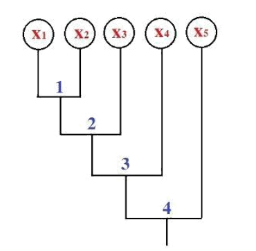
5 cụm
2 cụm
1 cụm
4 cụm
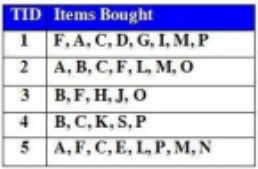
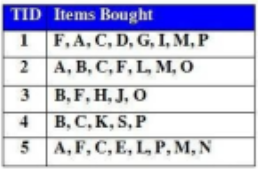
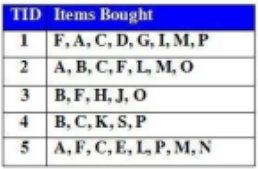
F:4, C:4, A:3, C:3, M:3, P:3
C:4, A:3, C:3, M:3, P:3
F:4, C:4
A:3, C:3, M:3, P:3
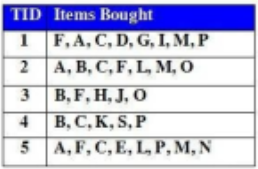
FCAM:3
FCAM:2
FC:4
FCAM:4
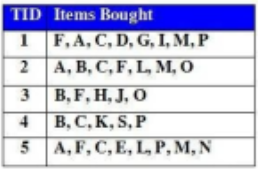
{F:2, C:2, A:2} và { F:1, C:1, A:1, B:1}
{F:2, C:2, A:2}
F:1, C:1, A:1
F: 3, C:3, A:3
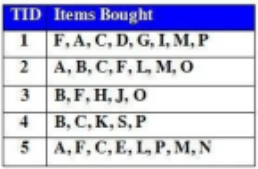
{F:2, C:2, A:2, M:2} và { C:1, B:1}
{F:2, C:2, A:2, M:2}
C:3
F: 3, C:3, A:3
{C:3}| p
{CF:3}|p
{C:4}|p
Cây điều kiện là rỗng
{F:3, C:3}| p
{CF:3}|p
{C:4}|p
Cây điều kiện là rỗng
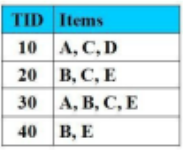
BA-->E
BC -->E
C--> E
B-->C
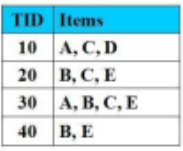
B-->E
A-->D
C--> E
AB-->C
B-->CE
A-->D
C--> E
AB-->C
{A, C}
{A, E}
{A, C, D}
{B, C, D}
{B, E}
{A, E}
{A, C, D}
{B, C, D}
Không có tập nào
{A, E}
{A, C, D}
{B, E}
{A, C, D}
{A, C}
{E, B}
{B, C}
{BC-->E, B-->E}
A-->D
AC--> E
B-->C
L1={{A}, {B}, {C}, {E}}
L1={{A}, {B}, {C}, {D}}
L1={{A}, {B}, {D}, {E}}
L1={{A}, {D}, {C}}
Không có tập nào
{A, E}
{A, C, D}
{B, C, D}
3 lần
2 lần
4 lần
1 lần
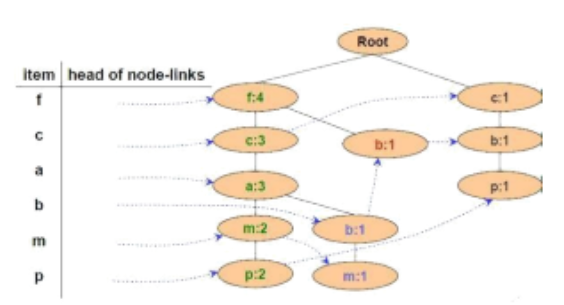
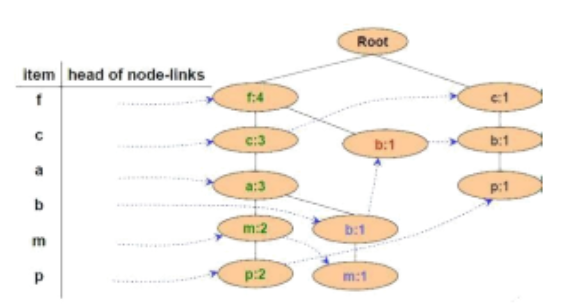
Cho FP-Tree như hình vẽ, mũi tên nét đứt biểu thị cho:
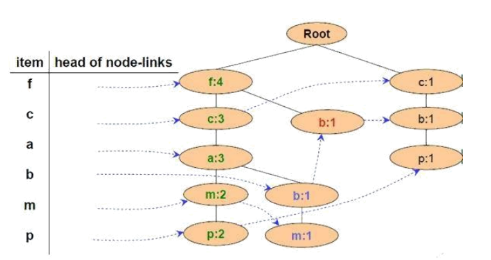
Con trỏ xuất phát từ bảng đầu mục, trỏ vào nút sinh ra đầu tiên có cùng tên. Nút sinh ra sau có con trỏ từ nút cùng tên sinh ra ngay trước đó trỏ vào
Đường đi trên cây
Nút sinh ra sau trỏ vào nút cùng tên sinh ra trước
Hướng để duyệt cây
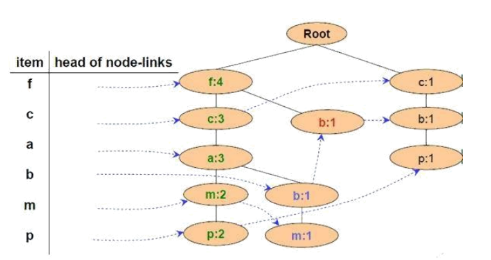
{f:2, c:2, a:2, m:2} và {c:1, b:1}
{f:3, c:3, a:3, m:2}
{f:4, c:3, a:3, m:2}
{f:2, c:2, a:2, m:2, p:2} và {c:1, b:1, p:1}
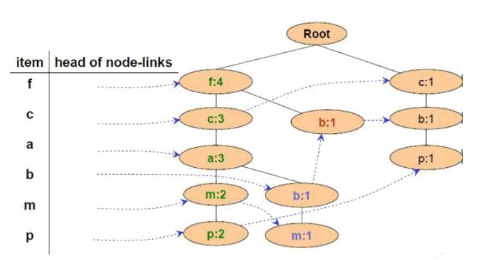
{f:2, c:2, a:2}, {f:1, c:1, a:1, b:1}
{f:4, c:4, a:3}, {f:4, c:3, a:3, b:1}
{f:2, c:2, a:2, m:2}, {f:1, c:1, a:1, b:1, m:1}
{f:2, c:2, a:2, m:2, p:2} , {c:1, b:1, p:1}
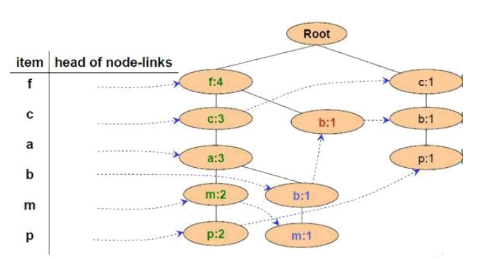
{f:3, c:3}
{f:4, c:3}
{f:4, c:3, a:3}
{f:3, c:3, a:3
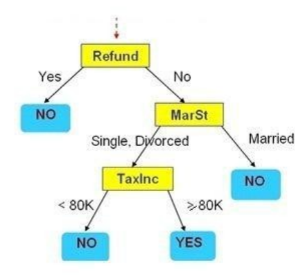
No
Yes
Không phân lớp được
Thiếu thông tin để kết luận
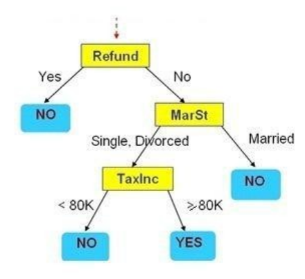
No
Yes
Không phân lớp được
Thiếu thông tin để kết luận
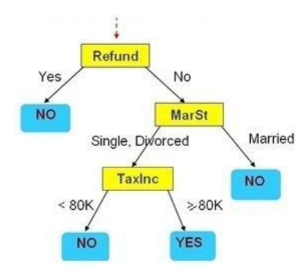
Yes
No
Không phân lớp được
Thiếu thông tin để kết luận
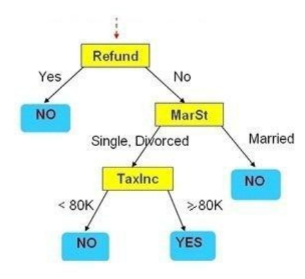
Yes
No
Không phân lớp được
Married
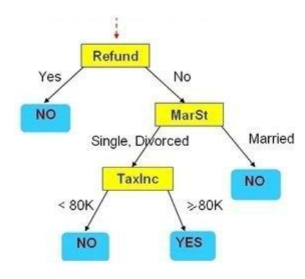
4 luật
2 luật
1 luật
Nhiều luật
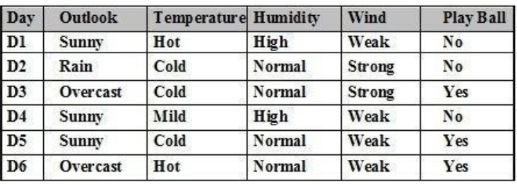
Entropy(C)=1
Entropy(C)=3
Entropy(C)=0.5
Entropy(C)=6
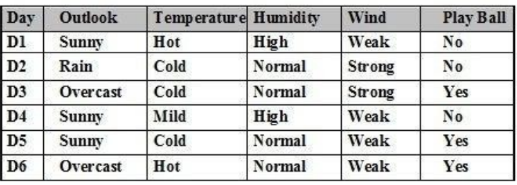
Giá trị khác
Entropy(Outlook = ‘Sunny’)=1
Entropy(Outlook = ‘Sunny’)=0.5
Entropy(Outlook = ‘Sunny’)=0
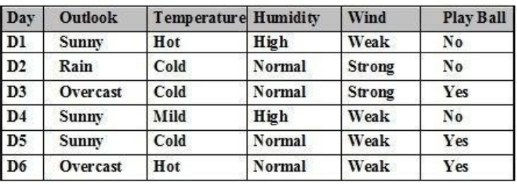
Giá trị khác
Entropy(Outlook)=1
Entropy(Outlook)=0.5
Entropy(Outlook)=0
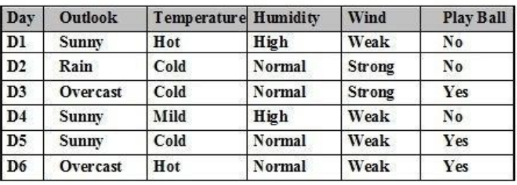
2/3
1/3
0/3
Giá trị khác
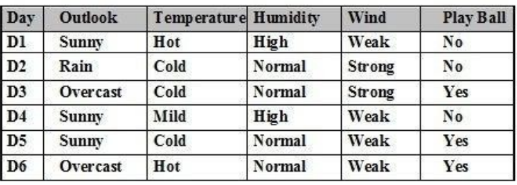
0/3
1/3
2/3
Giá trị khác
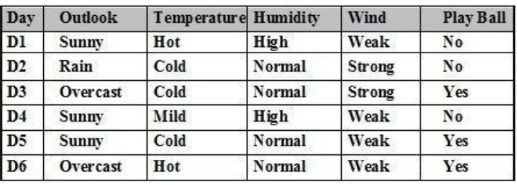
2/3
1/3
0/3
Giá trị khác
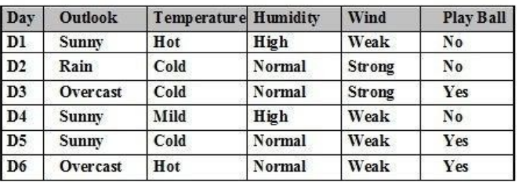
1/2
1/3
0/3
Giá trị khác
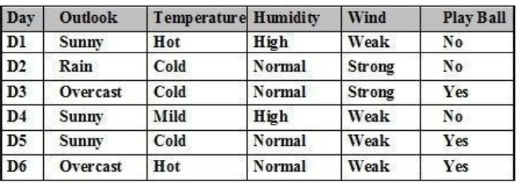
4/6
3/6
2/6
Giá trị khác
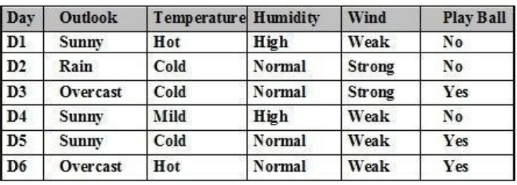
4 tổ hợp
5 tổ hợp
6 tổ hợp
2 tổ hợp
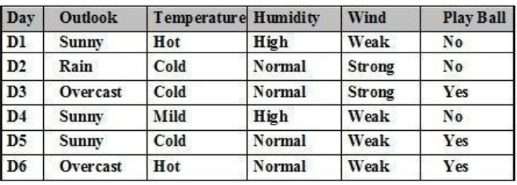
6 tổ hợp
5 tổ hợp
4 tổ hợp
2 tổ hợp
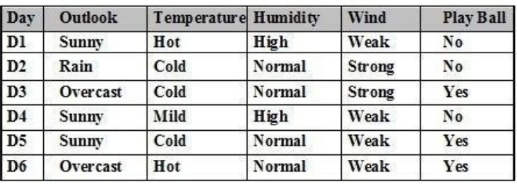
4 tổ hợp
1 tổ hợp
6 tổ hợp
2 tổ hợp
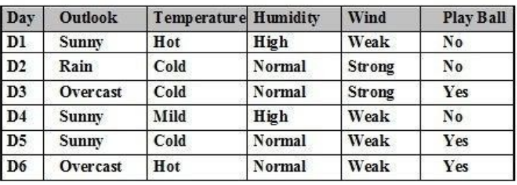
1 tổ hợp
4 tổ hợp
6 tổ hợp
2 tổ hợp
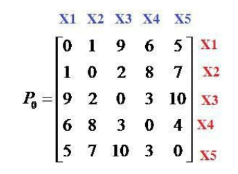
bằng 2
bằng 3
bằng 0
bằng 9
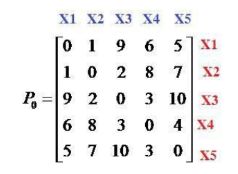
bằng 3
bằng 2
bằng 0
bằng 9
bằng 9
bằng 3
bằng 1
bằng 2
cấp 4
cấp 5
cấp 1
cấp 3
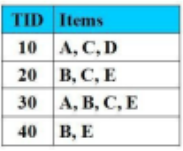
L2={{A,C}, {B,C}, {B,E}, {C,E}}
L2={{ A,D}, {B,D}, {B,E}, {C,E}}
L2= {{B,C}, {B,E}, {C,E}}
L2= {{A,C}, {C,E}}
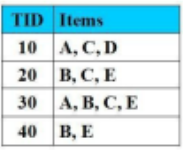
L3={{B, C, E}}
L3={{A,B, C} và {A,C,E}}
L3={{A,C,E} và {B,C,E }}
L3={{A,B,C,}}
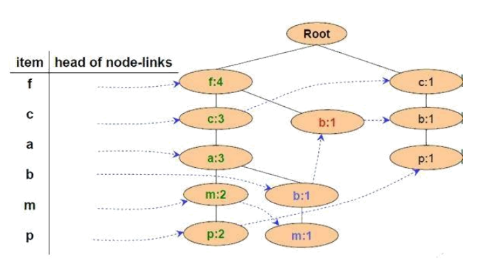
Cây rỗng
{f:4}
{f:4, c:1}
{f:3, c:3, a:3
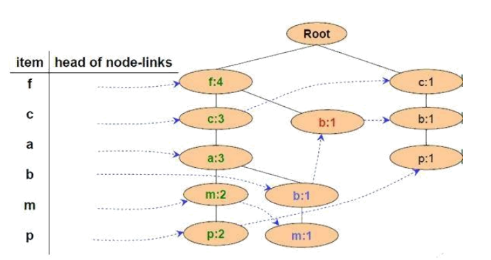
{f:4, c:3}
{f:3, c:3}
{f:4, c:3, a:3}
{f:3, c:3, a:3
Cho đồ thị như hình vẽ. Từ đồ thị ta thấy:
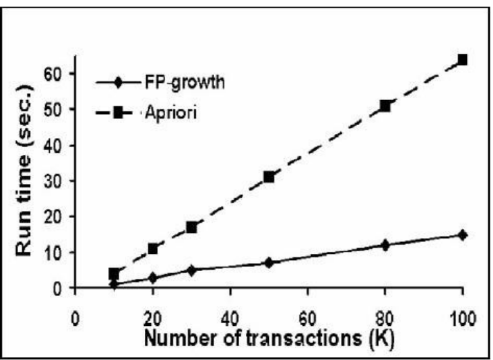
Với cùng số lượng giao dịch như nhau, thời gian thực thi của thuật toán FP-Growth luôn nhiều hơn thời gian thực thi của thuật toán Apriori
Với cùng số lượng giao dịch như nhau, thời gian thức thi thuật toán FP-Growth luôn ít hơn thời gian thực thi thuật toán Apriori
Thuật toán Apriori thực hiện nhanh hơn thuật toán FP-Growth
Hai thuật toán FP-Growth và Apriori đều thức thi với thời gian rất nhỏ.
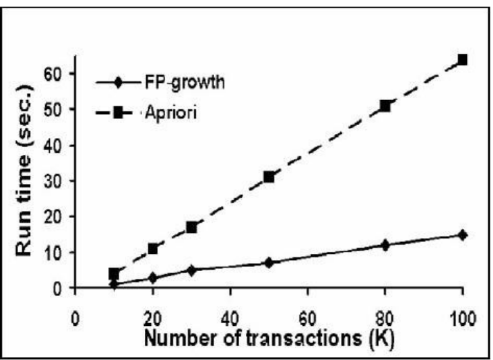
Với cùng số lượng giao dịch như nhau, thời gian thức thi thuật toán FP-Growth luôn ít hơn thời gian thực thi thuật toán Apriori
Thuật toán Apriori thực hiện nhanh hơn thuật toán FP-Growth
Khi số lượng giao tác rất nhỏ, thời gian thực thi của 2 thuật toán FP-Growth và Apriori là tương đương
Thuật toán FP-Growth thực hiện nhanh hơn thuật toán Apriori
Cho đồ thị như hình vẽ, đồ thị trên biểu diễn gì ?
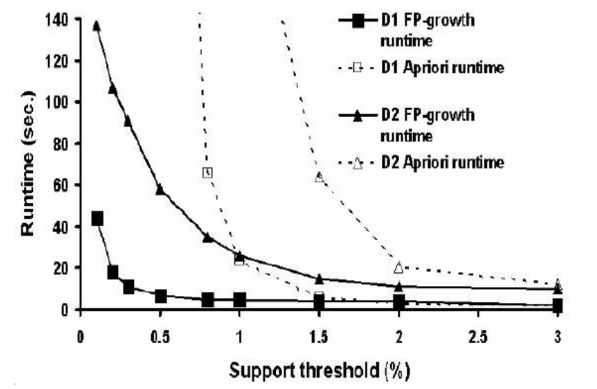
So sánh giữa Thời gian thực thi (tính bằng giây) của 2 thuật toán FP-Growth và Apriori trên 2 Database D1 và Database D2
So sánh giữa Thời gian thực thi (tính bằng giây) của 2 thuật toán FP-Growth và Apriori theo ngưỡng của độ hỗ trợ trên 2 Database D1 và Database D2
So sánh 2 thuật toán FP-Growth và Apriori theo ngưỡng độ tin cậy
Mối quan hệ giữa 2 thuật toán FP-Growth và Apriori
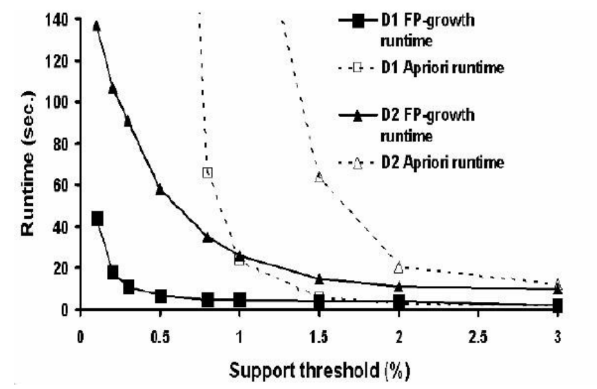
Với cùng ngưỡng của độ hỗ trợ, thời gian thực thi của thuật toán FP-Growth luôn nhiều hơn thời gian thực thi của thuật toán Apriori
Với cùng ngưỡng của độ hỗ trợ, thời gian thức thi thuật toán FP-Growth luôn ít hơn thời gian thực thi thuật toán Apriori
Thuật toán Apriori thực hiện nhanh hơn thuật toán FP-Growth
Hai thuật toán FP-Growth và Apriori đều thức thi với thời gian rất nhỏ.